前言
隨著技術持續演進,高效能運算(HPC)與人工智慧(AI)應用已深度融入日常生活。談到提升運算效能,CPU 和 GPU 常成為焦點,然而系統記憶體扮演的角色同樣關鍵,卻時常被忽略。
記憶體是電腦在處理過程中暫存資料的核心元件。容量與頻寬直接影響整體效能。但傳統 DRAM 記憶體技術正面臨極限。包括主機板插槽數量與高容量模組價格成本過高等問題。
Compute Express Link(CXL)是一項新技術,透過 PCIe 介面擴充系統記憶體。雖然 CXL 記憶體的速度略低於主記憶體,但它能提供額外資源,以更具彈性與成本效益的方式突破傳統架構限制,成為推動次世代運算架構的關鍵。
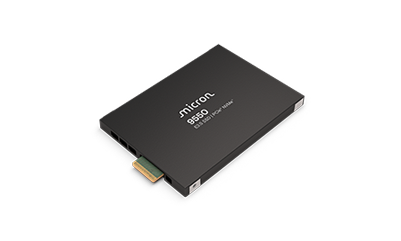
Micron 與技嘉攜手,使用技嘉 R284-A91-AAL3 CXL 伺服器、Micron CZ122 CXL 記憶體擴充模組、DDR5 RDIMM 與 NVMe SSD,進行一系列真實情境測試。展示所使用的組件如下:
 |  |  |  |
|---|---|---|---|
GIGABYTE R284-A91-AAL3• 搭載 2 顆® Xeon® 6 處理器 • 12 通道 DDR5 RDIMM 記憶體 • 16 個 E3.S 2T CXL 擴充槽 • 4 個 E3.S Gen5 NVMe 固態硬碟 | Micron CXL CZ122 Module• 容量選項:128GB / 256GB • 完整支援 CXL 2.0 • Type 3 記憶體擴充模組 • 採用 E3.S 2T 外型規格 | Micron DDR5 RDIMM• 模組容量:128GB • 傳輸速度:6400 MT/s • 採用創新 1β 技術 | Micron 9550 NVMe SSD• 容量:15TB • 支援 NVMe 2.0 / OCP 2.0 • 採用 G8 TLC NAND • E3.S 1T 外型規格 |
我們將測試聚焦於三大核心效益:
- CXL 記憶體頻寬擴充
- CXL 記憶體容量擴充
- CXL 成本效益分析
基於軟體的加權交錯技術
在評估效能之前,讓我們先來了解 CXL 面臨的挑戰:其效能相對於直接接上的主記憶體較低。與透過專屬通道連接 CPU 的 DRAM 不同,CXL 記憶體是透過 PCIe 介面運作,這樣的間接方式會增加存取延遲,導致 CPU 存取 CXL 記憶體所需時間較長。
為了善用 CXL 記憶體,我們採用了「基於軟體的加權交錯(Weighted Interleaving)」技術,根據不同工作負載特性,分配資料至 DRAM 與 CXL ,達成更佳效能與頻寬利用。測試過程使用 Intel 的 Memory Latency Checker(MLC)來評估不同工作負載下的頻寬與延遲,並透過微型基準測試進行不同讀寫模式與 DRAM/CXL 配比的效能分析。
每項測試皆使用了依權重分配的交錯方式。例如:
想像你正從一個城市開車到另一個城市。有四條快速公路(DRAM),但車多開始塞車。這時你加入幾條較慢的側道(CXL)。交錯策略決定交通怎麼分流,而「加權」則決定各自的配比。這不只是速度問題,而是更聰明的流量管控。
Linux kernel 6.9 版以上開始支援這項加權交錯功能,能夠更細緻地控制 DRAM 與 CXL 之間的記憶體配置,依據不同工作負載特性進行最佳化配置,即使兩者延遲與頻寬不同,也能達到更佳的資料流效率。
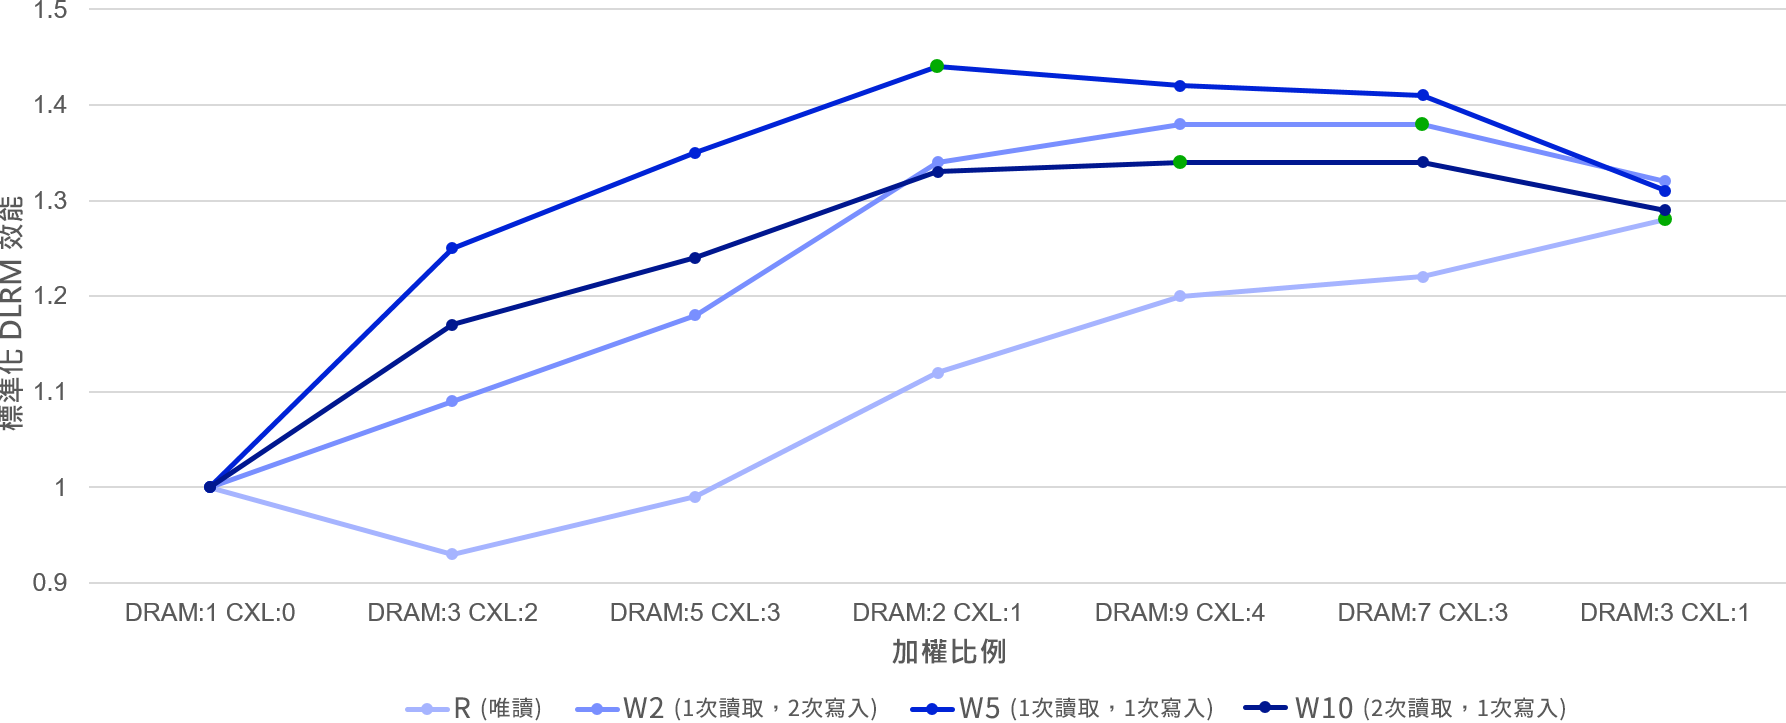
為了善用 CXL 記憶體,我們採用了「基於軟體的加權交錯(Weighted Interleaving)」技術,根據不同工作負載特性,分配資料至 DRAM 與 CXL ,達成更佳效能與頻寬利用。測試過程使用 Intel 的 Memory Latency Checker(MLC)來評估不同工作負載下的頻寬與延遲,並透過微型基準測試進行不同讀寫模式與 DRAM/CXL 配比的效能分析。
每項測試皆使用了依權重分配的交錯方式。例如:
- DRAM 與 CXL 比例為 3:1,代表 75% 的資料流量送至 DRAM,25% 則送至 CXL。
Linux kernel 6.9 版以上開始支援這項加權交錯功能,能夠更細緻地控制 DRAM 與 CXL 之間的記憶體配置,依據不同工作負載特性進行最佳化配置,即使兩者延遲與頻寬不同,也能達到更佳的資料流效率。
| DRAM 權重 | CXL 權重 | 標準化頻寬 |
|---|---|---|
| 1 | 0 | 1.00 |
| 2 | 1 | 1.12 |
| 5 | 2 | 1.25 |
| 3 | 1 | 1.28 |
| 工作負載:R (唯讀) | ||
| DRAM 權重 | CXL 權重 | 標準化頻寬 |
|---|---|---|
| 1 | 0 | 1.00 |
| 3 | 2 | 1.22 |
| 2 | 1 | 1.34 |
| 7 | 3 | 1.38 |
| 工作負載:W2 (1次讀取,2次寫入) | ||
| DRAM 權重 | CXL 權重 | 標準化頻寬 |
|---|---|---|
| 1 | 0 | 1.00 |
| 3 | 2 | 1.25 |
| 5 | 3 | 1.35 |
| 2 | 1 | 1.44 |
| 工作負載:W5 (1次讀取,1次寫入) | ||
| DRAM 權重 | CXL 權重 | 標準化頻寬 |
|---|---|---|
| 1 | 0 | 1.00 |
| 3 | 2 | 1.18 |
| 2 | 1 | 1.33 |
| 9 | 4 | 1.34 |
| 工作負載:W10 (2次讀取,1次寫入) | ||
CXL 記憶體頻寬擴充 — 帶來更高效能
以下內容探討 CXL 在實際工作負載中的表現。
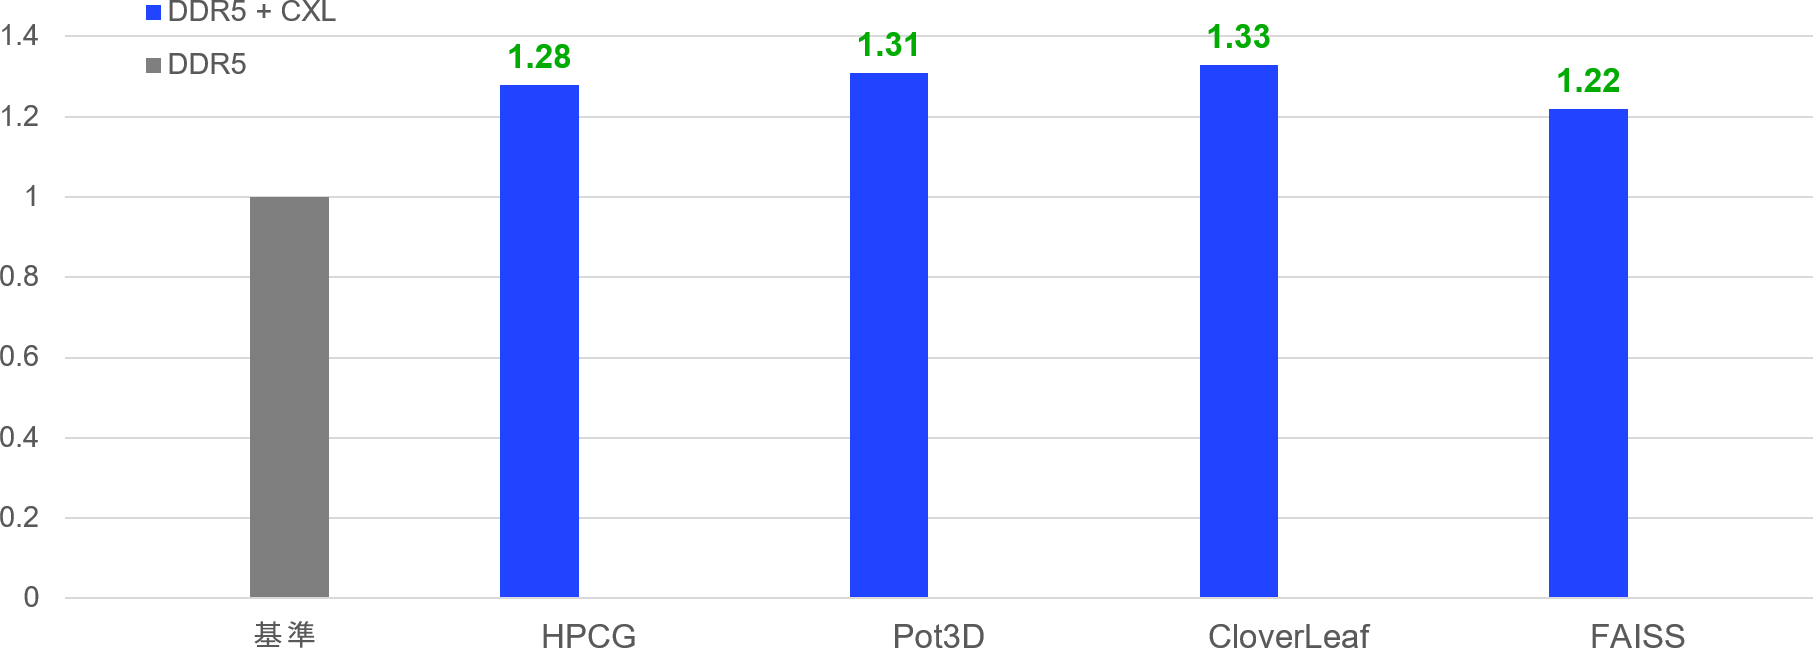
在記憶體使用密集的應用(如 HPC 與 AI)中,提升記憶體頻寬能顯著增強效能,這點從我們的結果中獲得驗證。
四個測試工作負載的效能提升幅度為 22% 至 33%,平均幾何成長為 28%。
在記憶體使用密集的應用(如 HPC 與 AI)中,提升記憶體頻寬能顯著增強效能,這點從我們的結果中獲得驗證。
四個測試工作負載的效能提升幅度為 22% 至 33%,平均幾何成長為 28%。
| HPCG | |||
|---|---|---|---|
| DRAM 權重 | CXL 權重 | 效能 (GFLOPS) | 提升倍數 |
| 1 | 0 | 94.32 | 1.00 |
| 3 | 1 | 120.75 | 1.28 |
| Pot3D | |||
|---|---|---|---|
| DRAM 權重 | CXL 權重 | 執行時間 (秒) | 加速比 |
| 1 | 0 | 706 | 1.00 |
| 5 | 2 | 539 | 1.31 |
| CloverLeaf | |||
|---|---|---|---|
| DRAM 權重 | CXL 權重 | 執行時間 (秒) | 加速比 |
| 1 | 0 | 116.74 | 1.00 |
| 9 | 4 | 87.53 | 1.33 |
| FAISS | |||
|---|---|---|---|
| DRAM 權重 | CXL 權重 | 輸出詞元延遲 (毫秒) | 加速比 |
| 1 | 0 | 2.28 | 1.00 |
| 2 | 1 | 1.87 | 1.22 |
測試工作負載簡介:
| HPC 工作負載 | |
|---|---|
| High-Performance Conjugate Gradients (HPCG) | 使用多重網格預處理共軛梯度法求解大型且稀疏的線性方程組。適用於需要大量記憶體存取的科學與工程工作負載。 |
| Pot3D | 模擬三維泊松方程。用於分子動力學與涉及三維靜電位問題的物理模擬。 |
| CloverLeaf | 在網格上模擬氣體流動的可壓縮歐拉方程式,應用於天體物理、核子模擬及工業衝擊波建模等領域。 |
| AI 工作負載 | |
| FAISS | 採用最鄰近搜索(ANN)技術。常見於推薦系統、向量搜尋與自然語言處理(NLP)嵌入等 AI 應用。 |
CXL 記憶體容量擴充 — 滿足大數據需求
CXL 的一大優勢是能突破主機板插槽限制,提供更大記憶體空間,並降低高容量 DIMM 所需成本。
我們接著使用分析型資料庫引擎 DuckDB 進行 TPC-H 與 TPC-DS 兩項基準測試。TPC-H 評估簡化結構下的分析查詢,TPC-DS 則模擬實際零售場景中複雜混合查詢類型。
採用 DRAM + CXL + 加權交錯的測試結果如下:
結果顯示,CXL 有助於強化決策支援系統與大數據應用的處理能力。這證明 CXL 不只是速度提升,更是讓原本無法容納的大型工作負載得以執行的關鍵。
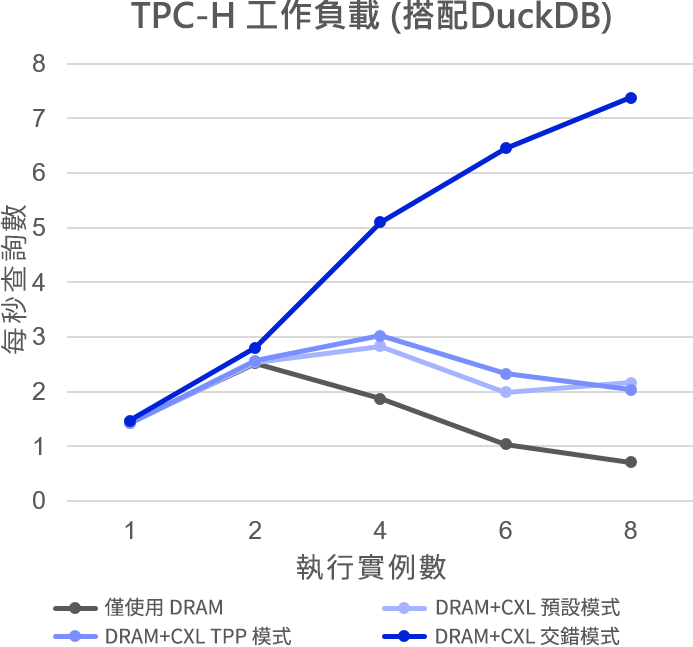
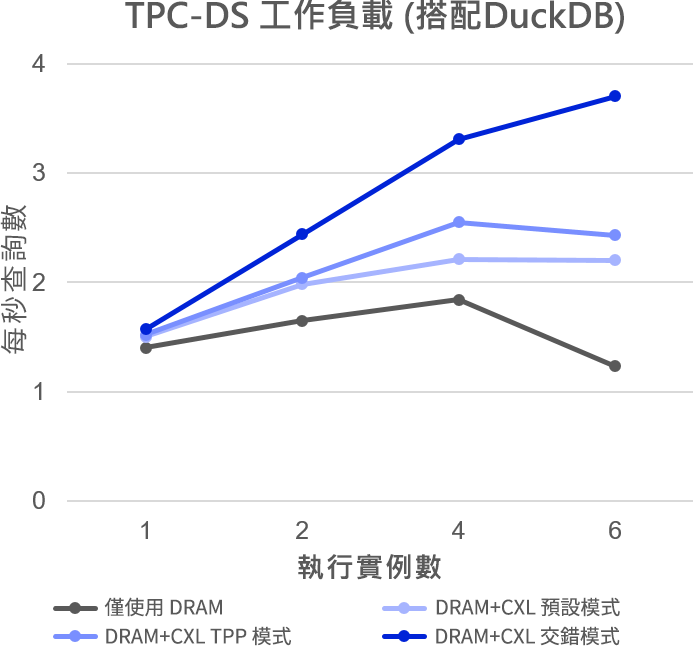
我們接著使用分析型資料庫引擎 DuckDB 進行 TPC-H 與 TPC-DS 兩項基準測試。TPC-H 評估簡化結構下的分析查詢,TPC-DS 則模擬實際零售場景中複雜混合查詢類型。
採用 DRAM + CXL + 加權交錯的測試結果如下:
- TPC-H 效能提升 2.93 倍
- TPC-DS 效能提升 2.01 倍
結果顯示,CXL 有助於強化決策支援系統與大數據應用的處理能力。這證明 CXL 不只是速度提升,更是讓原本無法容納的大型工作負載得以執行的關鍵。
| 策略 | 實例數 | 每分鐘查詢數 | 最大記憶體 (TB) | 效能提升倍數 |
|---|---|---|---|---|
| 僅使用 DRAM | 2 | 2.52 | 1.44 | 1.00 |
| DRAM+CXL 預設模式 | 4 | 2.83 | 1.87 | 1.12 |
| DRAM+CXL TPP 模式 | 4 | 3.02 | 1.93 | 1.20 |
| DRAM+CXL 交錯模式 | 8 | 7.38 | 2.86 | 2.93 |
| 策略 | 實例數 | 每分鐘查詢數 | 最大記憶體 (TB) | 效能提升倍數 |
|---|---|---|---|---|
| 僅使用 DRAM | 4 | 1.84 | 1.56 | 1.00 |
| DRAM+CXL 預設模式 | 4 | 2.21 | 2.61 | 1.20 |
| DRAM+CXL TPP 模式 | 4 | 2.55 | 3.64 | 1.39 |
| DRAM+CXL 交錯模式 | 6 | 3.70 | 3.77 | 2.01 |
CXL 成本效益分析 — 節省支出,效能不打折
最後是成本效益分析。
我們透過執行對記憶體需求與延遲最為敏感的深度學習推薦模型(DLRM)進行效能評估。此模型採用大量嵌入表,為嚴苛的測試案例。若 CXL 表現仍佳,代表其可用於更多元工作負載。
實測中效能影響相當小:
這表示企業可減少採購昂貴的 128 GB RDIMM(價格可能是 64 GB 模組的三倍),以較低成本維持接近完整的系統效能。在大規模部署下,節省下的金額將相當可觀。
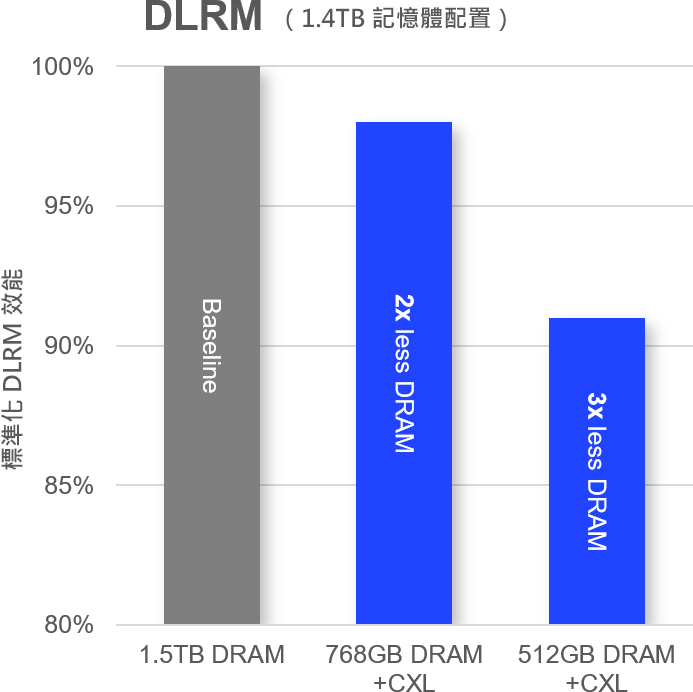
我們透過執行對記憶體需求與延遲最為敏感的深度學習推薦模型(DLRM)進行效能評估。此模型採用大量嵌入表,為嚴苛的測試案例。若 CXL 表現仍佳,代表其可用於更多元工作負載。
實測中效能影響相當小:
- 當 50% 記憶體透過 CXL 分配時,效能僅下降約 2%
- 當 67% 記憶體使用 CXL 時,效能約下降 9%
這表示企業可減少採購昂貴的 128 GB RDIMM(價格可能是 64 GB 模組的三倍),以較低成本維持接近完整的系統效能。在大規模部署下,節省下的金額將相當可觀。
| 設定 | DLRM 基準測試 | 策略 | 標準化效能 |
|---|---|---|---|
| 1.5TB 僅使用 DRAM | 17899 | - | 1 |
| 768GB DRAM + CXL | 17555 | 軟體交錯配置 | 0.98 |
| 512GB DRAM + CXL | 16250 | 軟體交錯配置 | 0.91 |
*實際成本節省會因市場價格波動,詳細資訊請聯絡業務窗口。
結論
本次Micron與技嘉的合作展示證明,CXL 不僅為未來趨勢,更已具備實際應用價值。無論是建構 AI 模型、分析龐大資料集,或執行科學模擬運算,CXL 皆能帶來:
CXL正加速推動現代運算向更高效能、更高擴展性的方向邁進。
若對展示中的技術或產品有任何疑問或合作機會,歡迎聯繫我們!
- 更高記憶體頻寬,加速效能
- 更大記憶體容量,處理更多工作負載
- 更低成本,而效能近乎不減
CXL正加速推動現代運算向更高效能、更高擴展性的方向邁進。
若對展示中的技術或產品有任何疑問或合作機會,歡迎聯繫我們!