Distributed Computing
Computación distribuida
¿Qué es?
La computación distribuida es un modelo en el que distintos componentes de un software se ejecutan en varios equipos, pero funcionan como un único sistema. Por ejemplo, cada vez que realizas una búsqueda desde un navegador web, tu solicitud es procesada en realidad por distintos servidores ubicados en diferentes lugares. Cada uno prepara su respuesta de forma independiente. A continuación, los resultados se agregan y se muestran en el dispositivo desde el que hiciste la solicitud, sin que sepas cuántos servidores han logrado ayudarte a encontrar la información —o han fallado al intentarlo—. Este es el potencial de la computación distribuida: permite que un equipo aproveche los recursos de otros, al tiempo que evita que el fallo de uno de ellos ponga en riesgo toda la tarea.
Conviene señalar que, aunque la computación distribuida es el término general que engloba otros conceptos similares, como la computación paralela y la computación en malla, los métodos son diferentes. La computación paralela requiere un nivel de coordinación y de uso compartido de recursos mucho mayor entre cada nodo, mientras que la computación en malla suele ser más heterogénea e implica equipos conectados de forma menos estrecha. La modalidad de computación distribuida más adecuada dependerá en gran medida de la tarea que necesites realizar.
Conviene señalar que, aunque la computación distribuida es el término general que engloba otros conceptos similares, como la computación paralela y la computación en malla, los métodos son diferentes. La computación paralela requiere un nivel de coordinación y de uso compartido de recursos mucho mayor entre cada nodo, mientras que la computación en malla suele ser más heterogénea e implica equipos conectados de forma menos estrecha. La modalidad de computación distribuida más adecuada dependerá en gran medida de la tarea que necesites realizar.
¿Por qué la necesita?
Los beneficios de la computación distribuida se resumen perfectamente en el viejo dicho: «no ponga todos los huevos en la misma cesta». La computación distribuida ofrece una redundancia rentable, ya que un gran número de equipos más pequeños pueden trabajar conjuntamente para alcanzar un objetivo común, y el fallo de cualquiera de ellos no afecta a todo el sistema. La escalabilidad también es mucho mayor al utilizar computación distribuida, ya que los nodos pueden añadirse o eliminarse según sea necesario. Si se emplea computación paralela para dedicar una gran cantidad de recursos informáticos a un único objetivo, es posible alcanzar el nivel de la computación de alto rendimiento (HPC).
¿Cómo ayuda GIGABYTE?
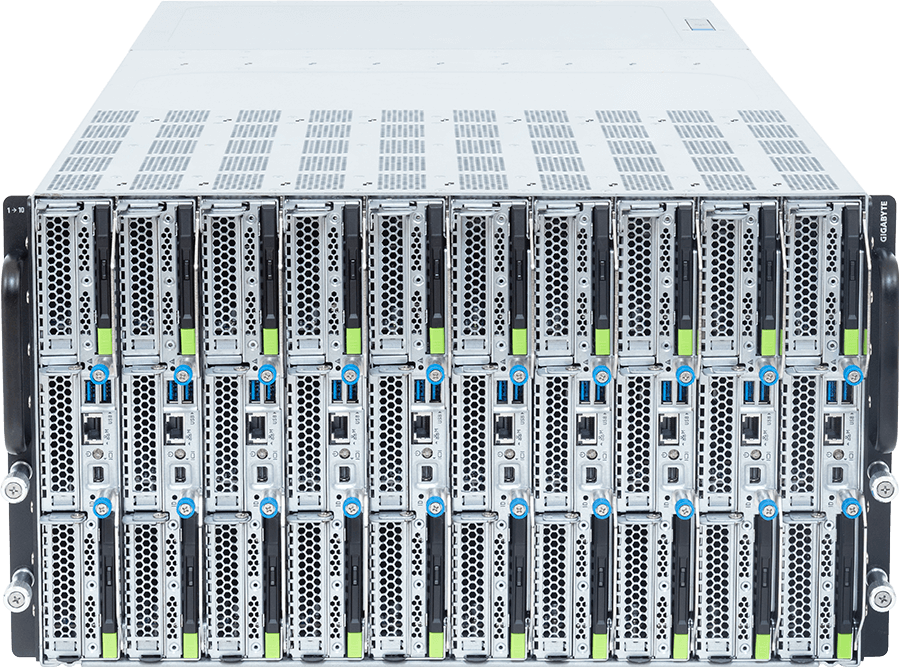
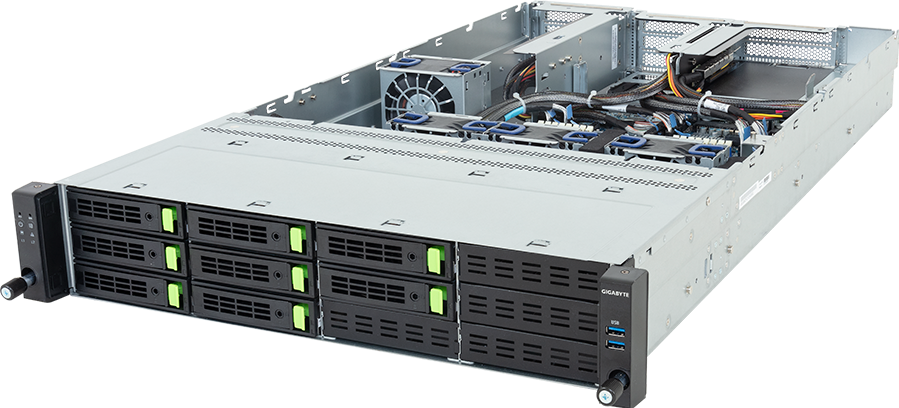
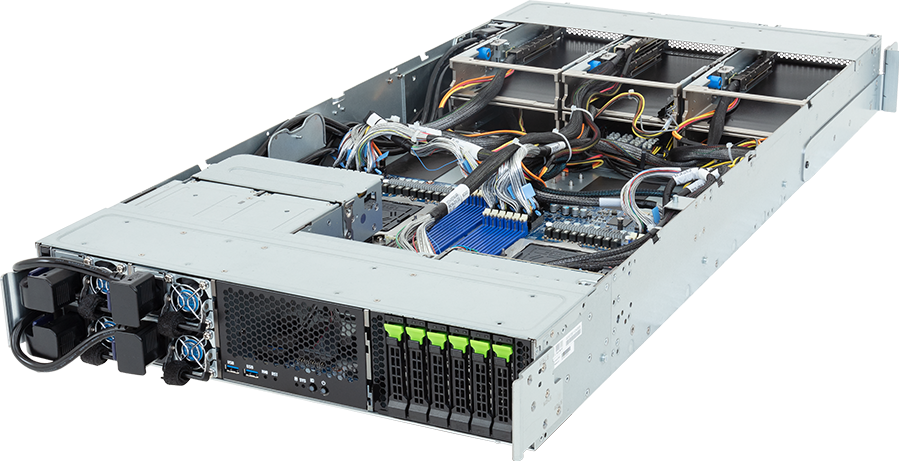
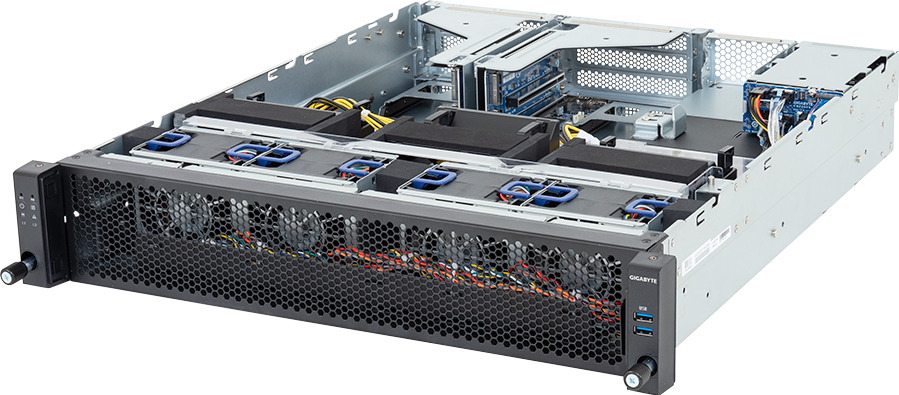
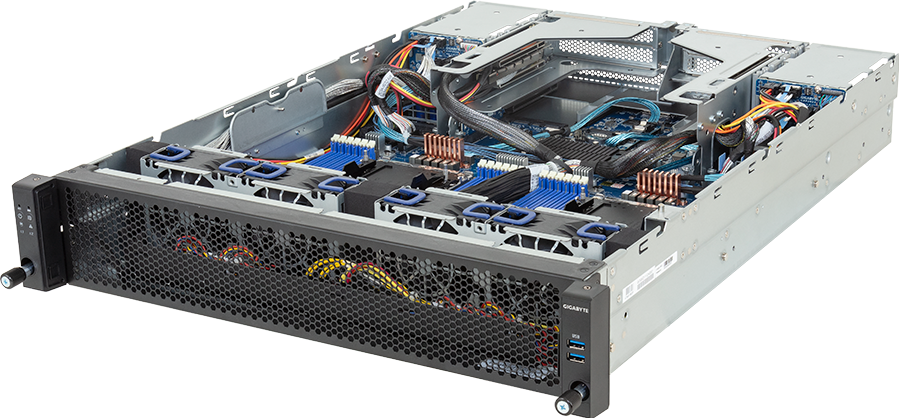
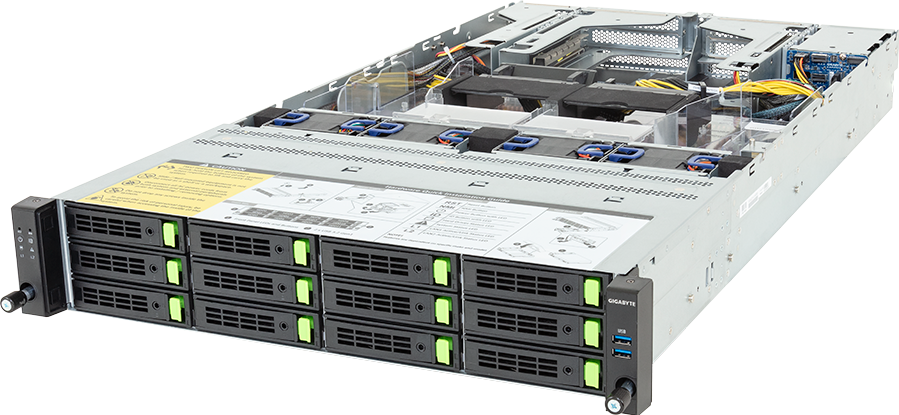
Por definición, la computación distribuida depende de un gran número de servidores que desempeñan funciones diferentes. Esta es precisamente la especialidad de GIGABYTE. Si busca servidores adecuados para la computación paralela, los servidores GPU de la serie G pueden ser la opción ideal, ya que combinan las ventajas de las CPU y las GPGPU mediante la computación heterogénea para ofrecer resultados excepcionales. Otras líneas de productos destacadas son los servidores de alta densidad de la serie H, que pueden alojar un gran número de nodos en formatos compactos; los servidores en rack de la serie R, versátiles y capaces de cubrir las carencias de su sistema de computación distribuida; y los servidores de almacenamiento de la serie S, que suelen utilizarse en grandes cantidades en el nodo de almacenamiento de un clúster de computación o una granja de servidores. En la computación en la nube, la distribución de las tareas de computación entre los centros de datos en la nube y los dispositivos de computación perimetral también puede considerarse una forma de computación distribuida. La solución de GIGABYTE para este escenario son los servidores perimetrales de la serie E, diseñados para ayudar a ampliar la cobertura en la periferia de la red.