高速傳輸: AI 基礎建設的「交通命脈」
隨著AI基礎建設發展,資料傳輸的重要性全面提升,運算重心從 CPU 轉向 GPU。大型 AI 模型的訓練動輒需要數千張 GPU 來處理 TB 至 PB 級資料,早已超越單一伺服器的負荷,這使得大規模的跨節點協同運算成為必要需求,而「高頻寬」和 「低延遲」的高速網路就成為關鍵。
在 AI 訓練階段,多 GPU 之間需要頻繁進行同步與整合,以確保模型參數一致,任何節點的延遲都可能影響整體訓練效率,或者讓GPU資源閒置,因此特別依賴穩定且快速的橫向資料傳輸(東西向流量)。而在推論階段,資料流向則是資料中心外部和內部資料傳遞(南北向流量),以強調即時回應與穩定服務,確保外部用戶的請求能即時獲得系統回應。
在 AI 訓練階段,多 GPU 之間需要頻繁進行同步與整合,以確保模型參數一致,任何節點的延遲都可能影響整體訓練效率,或者讓GPU資源閒置,因此特別依賴穩定且快速的橫向資料傳輸(東西向流量)。而在推論階段,資料流向則是資料中心外部和內部資料傳遞(南北向流量),以強調即時回應與穩定服務,確保外部用戶的請求能即時獲得系統回應。
從伺服器內部互連到網路拓樸: 打造高效的AI資料傳輸
隨著 AI 工廠規模擴大,因應不同階段的流量特性和應用,透過高速網路互連和網路架構拓樸,才能打造高效、高同步性且可擴展的AI基礎架構。接下來,我們將從伺服器內部、跨節點互連以及資料中心整體網路拓樸三個面向,解析傳輸技術的應用演進。
・ CXL(Compute Express Link):這項基於PCIe Gen5 的互連技術,讓 CPU 與 GPU/FPGA 等加速器能夠共用記憶體,減少資料重複搬移與複製。技嘉高效能伺服器 結合 PCIe Gen5 與 CXL 技術,能顯著加速 CPU-GPU 協作效率,優化 AI 即時推論與大規模分析應用。
- 1. 伺服器內部傳輸:加速 CPU 與GPU 間協作
・ CXL(Compute Express Link):這項基於PCIe Gen5 的互連技術,讓 CPU 與 GPU/FPGA 等加速器能夠共用記憶體,減少資料重複搬移與複製。技嘉高效能伺服器 結合 PCIe Gen5 與 CXL 技術,能顯著加速 CPU-GPU 協作效率,優化 AI 即時推論與大規模分析應用。
延伸閱讀:
《打造 AI 工廠的記憶體革命 ─ CXL 記憶體池的崛起》
《Micron 與技嘉 CXL 應用展示》
・GPU 互連技術:為提升 GPU 間溝通效率,AMD Infinity Fabric、 NVIDIA NVLink 等高速互連技術因應而生,這些技術讓 GPU 能夠繞過 CPU,以點對點方式直接通訊與共享資料,有效降低延遲、提升頻寬。 GIGABYTE GB200 NVL72 解決方案便採用最新的NVIDIA 第五代NVLink (1.8 TB/s GPU-GPU互連頻寬) 和NVLink Switch,將此機架級配置的36顆NVIDIA Grace™ CPU 與72顆Blackwell GPU 高速互連,實現「一機架等於一台超級 GPU」的效能表現。
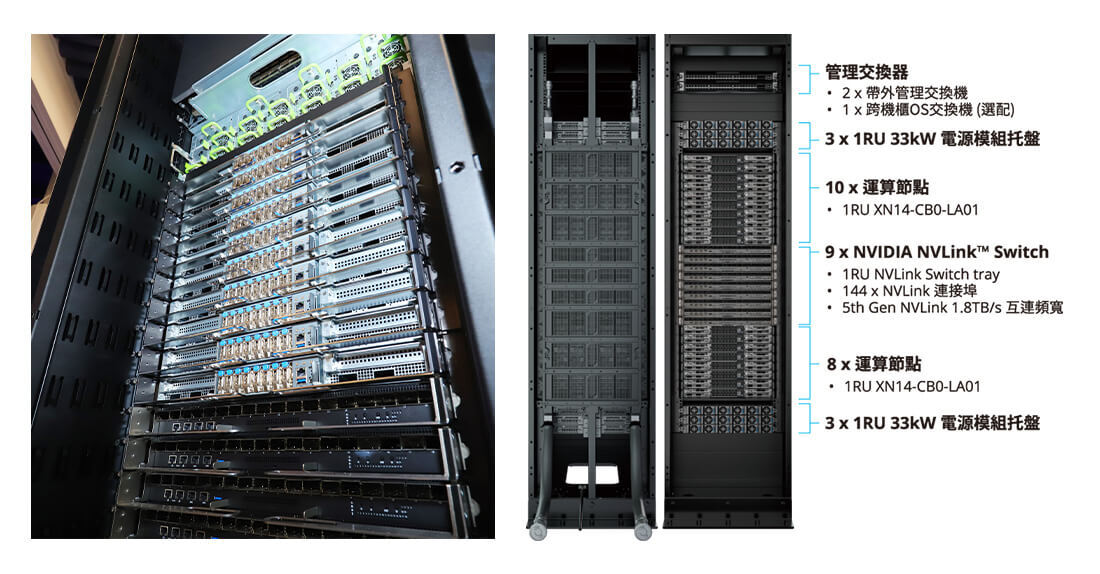
GIGABYTE GB200 NVL72 機架級解決方案
- 2. 跨節點之間的網路架構:建構高速低延遲 AI 訓練叢集
・乙太網(Ethernet) :資料中心最廣泛採用的網路標準,以其成熟、高相容性著稱。為滿足 AI 運算的高速低延遲需求,乙太網可透過 RoCE(RDMA over Converged Ethernet)協定實現 RDMA技術,讓伺服器間的資料傳輸能夠跳過 CPU,降低延遲並提升效能。同時,也能確保在高負載下降低封包遺失機率,避免訓練中斷與資源浪費。目前主流乙太網路標準已支援至 400Gbps,並邁向800Gbps,預計將成為新一代AI基礎架構的核心。GIGABYTE Intel® Gaudi® 3 AI 加速器的協同運算伺服器系列,便基於標準乙太網路開放架構,提供具成本效益且易擴展的AI部署方案。
・ InfiniBand:專為高效能運算設計,InfiniBand 具備極低的延遲與極高的頻寬,特別適合大量 GPU 同步運算和大型 AI 模型訓練。它內建高效率的遠端直接記憶體存取技術(RDMA),能讓資料傳輸更快且降低系統負擔。目前InfiniBand的主流標準達到400 Gbps,而業界正持續推動更高速的800Gbps版本,成為 AI 超級電腦和雲端資料中心的關鍵技術,未來,InfiniBand 的速度預計還會繼續提升。
- 3. 資料中心網路拓樸架構: 告別傳統三層架構,「胖樹」拓撲成新主流
因為在 AI 訓練和高效能運算中,最主要的流量模式是「東西向流量」,也就是數千台伺服器(特別是 GPU 伺服器)之間彼此頻繁地交換海量資料。如果繼續使用三層式架構,這些東西向流量仍必須層層上傳到核心層才能被轉發給另一台伺服器。這不僅會繞遠路,更會導致單點阻塞,所有流量都集中在核心層再轉發,就像高速公路必須經過同一個收費站,且因資料傳輸的路徑長且擁擠,導致更加延遲,甚至拖慢整個訓練進度。
為了突破此瓶頸,現代 AI 與HPC資料中心普遍採用胖樹(Fat-Tree)拓樸,基於葉脊結構(Spine-and-Leaf),明顯地提升可靠性和擴充性。胖樹的設計核心是將單一主幹道變成一個四通八達的網狀高速公路系統,藉由多條等距的互連路徑,確保任意兩台伺服器之間都有相同的傳輸距離,同時分散流量,避免集中於單一節點。這種設計能有效提供更高的頻寬與更低的延遲,非常適合 AI 訓練所需的大規模資料交換。
GIGABYTE GIGAPOD:基於胖樹拓撲的 AI 運算叢集解決方案
GIGAPOD是專為AI資料中心而生的整合式解決方案,單一氣冷配置可整合256顆GPU (8+1個機櫃),它的核心設計來自於無阻塞胖樹拓樸結構,把8+1的機櫃以主幹枝葉的概念展開,底層的每台伺服器的每顆GPU 與一張網卡配對成為一個組合(GPU-NIC pair),並分散連到8台枝葉交換器,接著,這些枝葉交換器再平均分配到4台主幹交換器,這樣一層層連上去,就形成了一棵「胖樹」,確保每條路徑都有足夠的頻寬,流量均衡分布,不造成單一路徑壅塞。這種設計能提供 均衡的流量分布與高頻寬連線,避免壅塞,同時支援 AI 訓練所需的 大規模橫向擴展,讓運算叢集在處理龐大模型時仍能維持高效與穩定。
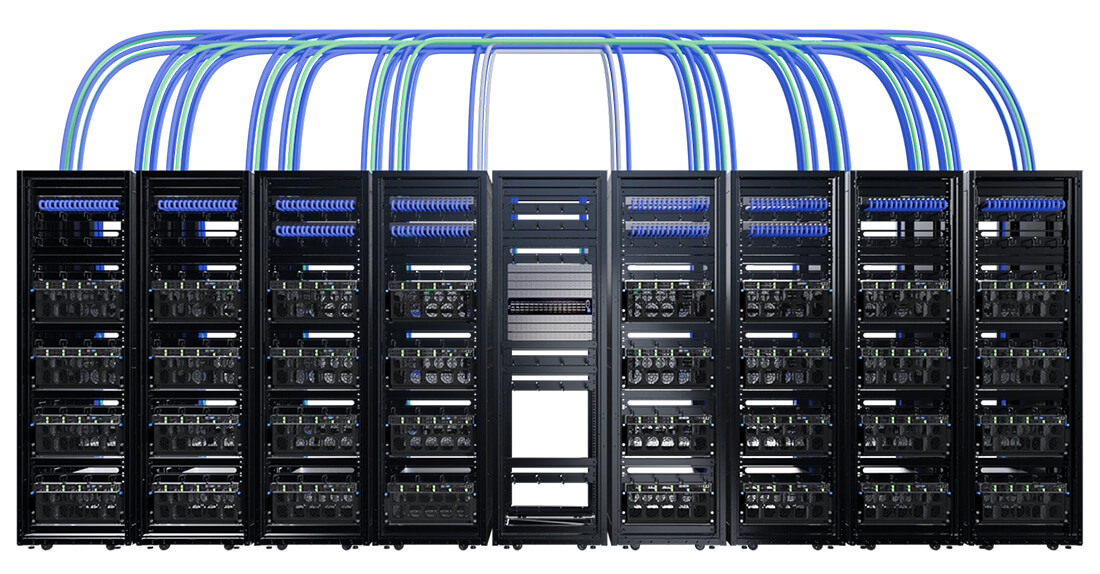
GIGABYTE GIGAPOD 整合式人工智慧資料中心解决方案
整個胖樹網路就像打通所有通往高速幹道的街道,使 GPU 節點能夠低延遲、高頻寬地互連。GIGAPOD 解決方案支援 NVIDIA® NVLink® 與 AMD Infinity Fabric™ 等高速 GPU 互連技術,即使分布於不同機櫃,GPU 仍可如同單機伺服器般高效協同運作,完美滿足 AI 訓練、推論及大規模平行運算的需求。
延伸閱讀:《如何用 GIGAPOD 加速全面 AI 革命》
延伸閱讀:《如何用 GIGAPOD 加速全面 AI 革命》
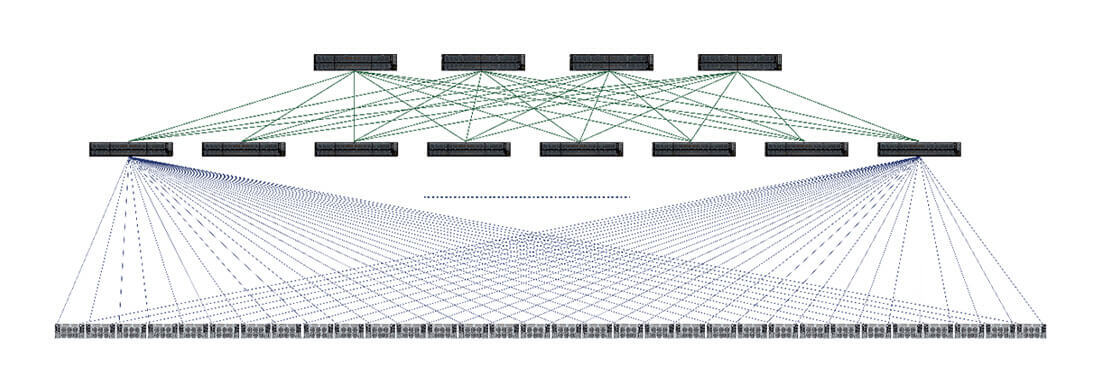
GIGAPOD胖樹結構
GIGABYTE 的整合解法:打造完整的一站式 AI 基礎建設服務
AI 訓練叢集的運算效能,不再僅取決於 GPU 的數量與算力,更仰賴 GPU 間與節點間資料傳輸的協同效率。從互連架構、網路拓樸到通訊協定,皆需整合考量,以建構高速、穩定且可擴展的基礎網路。然而網路架構不只是交換器與線路的堆疊,它牽涉到佈線路徑設計、交換器機櫃配置、線纜長度控制,以及與冷卻、供電等系統的整體協調。
因此,打造真正 AI-ready 的資料中心,需要的不是單點技術,而是涵蓋規劃、設計、施工到部署的全方位一站式服務,確保軟硬體與基礎設施完美融合,讓效能最大化。技嘉憑藉多年豐富的專業經驗,將解決方案推進至 L12等級的資料中心服務,已境成功為全球客戶部署大型 AI 資料中心,持續提供完整可靠的一站式 AI 基礎建設服務。
技嘉提供資料中心完整生命週期的產品及服務,包含可擴充性的基礎建設,並結合全球技術支援服務。從初期的專業顧問諮詢、場地與環配置、工程設計與施工,到系統部署,更整合了專屬的智慧管理平台 GPM(GIGABYTE POD Manager),協助資料中心基礎設施管理,我們為客戶打造無縫整合、一條龍的服務。這種一站式的服務模式,大幅簡化客戶的佈建流程,助力其穩健邁向 AI 基礎設施未來。
延伸閱讀: 《資料中心基礎建設》
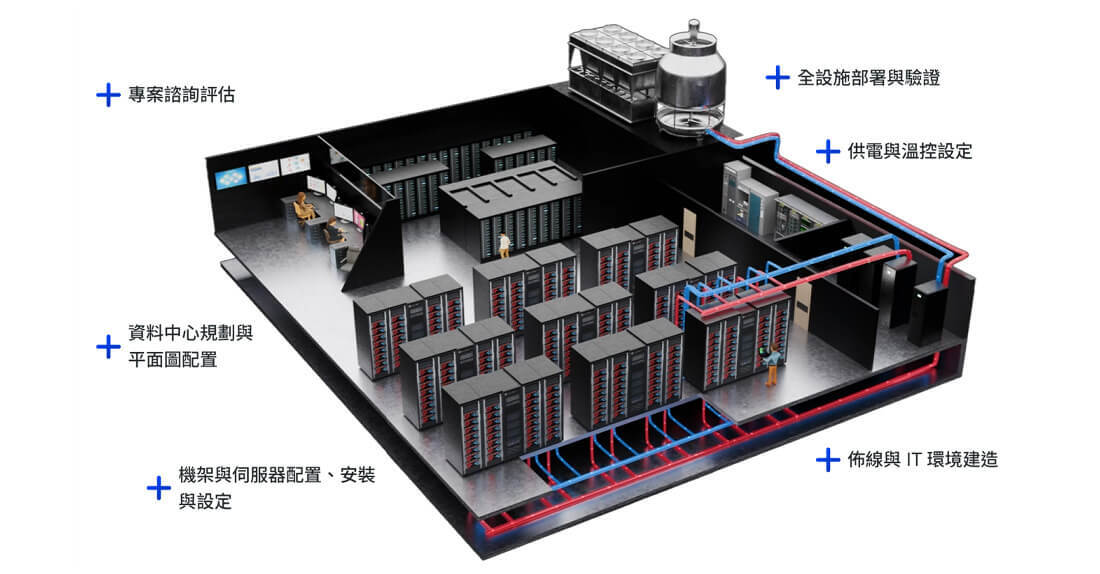
資料中心全生命週期解方與服務
引領 AI 基礎設施的未來趨勢與永續發展
面對日益嚴峻的能源與散熱挑戰,技嘉致力推動綠色永續發展,採用高效節能的冷卻系統,如液冷與浸沒式冷卻技術,協助企業實現碳中和目標。同時,為因應 AI 運算的複雜性,技嘉的智慧管理平台(GIGABYTE POD Manager)正持續升級,透過DCIM(資料中心基礎設施管理)與 AIOps(人工智慧運維)技術,實現即時監控、自動化資源分配與預測性維護,進一步提升運算效率並降低維運成本。
延伸閱讀: 《 DCIM x AIOps:助力AI持續翻新的關鍵趨勢》
技嘉持續憑藉豐富的實務經驗與技術專業,與客戶攜手打造具備長期競爭力的 AI 基礎設施,深化與生態系合作夥伴的協作,共同打造兼具創新、效率與永續的 AI 資料中心解決方案,構築智慧且永續的資料中心生態系。以軟硬體整合的完整系統推動 AI 持續前進,創造一個更智慧、更高效且具韌性的未來。
感謝您閱讀本篇趨勢文。若對於 AI基礎建設相關軟硬體及整合有任何疑問,歡迎透過聯繫我們,我們將會有專業團隊協助您挑選合適的產品解決方案。
延伸閱讀:
《資料中心轉型 AI Infrastructure,迎接 AI 工廠時代來臨》
《打造 AI 工廠的記憶體革命 ─ CXL 記憶體池的崛起》
參考資料:
1. Compute Express Link (CXL) 3.0 Specification : https://computeexpresslink.org
2. InfiniBand : https://www.infinibandta.org
3. Ethernet Technology Roadmap - Ethernet Alliance: https://ethernetalliance.org/roadmap
4. NVIDIA: https://www.nvidia.com/en-us/data-center/nvlink
5. AMD: https://www.amd.com/en/technologies/infinity-fabric
6. Intel : https://www.intel.com/content/www/us/en/products/details/discrete-gpus.html