整體架構
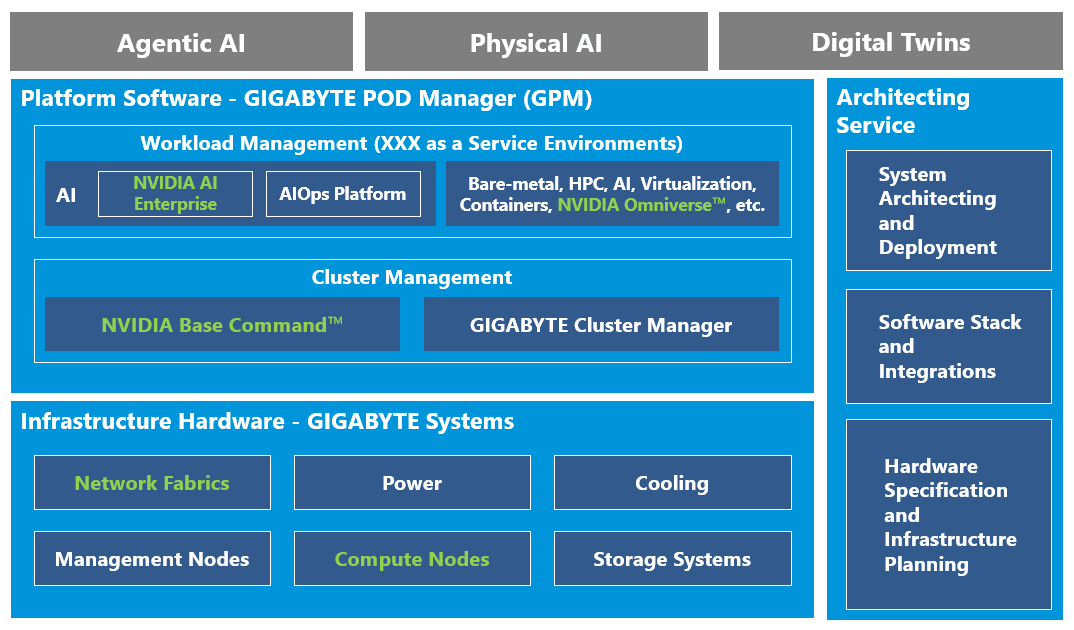
GPM 定位為管理平台軟體,管理底層 Infrastructure Hardware,包含伺服器、GPU、網路、電力、散熱等,與支持上層 AI/Agentic AI/Physical AI/Digital Twins 應用運行,並與 NVIDIA Base Command™ 等叢集管理軟體協同運作,提供從硬體規劃、軟體整合到系統部署的完整架構設計服務。
主要功能介紹

資料中心基礎設施管理
GPM 搭配 G-REX 集中管理節點,即時監測伺服器、網路交換器、儲存設備與電力/散熱基礎設施 (如 CDU、RDHx 等) 的健康狀況與使用率,並可於偵測到漏液等異常時即時警示,讓 IT 團隊快速回應、排除問題,確保資料中心穩定運行。

快速作業系統部署
透過自動偵測新設備與簡化安裝流程,GPM 讓基礎設施部署變得輕而易舉!其功能包括: 預設與可自訂的作業系統安裝模板,實現快速部署; 批次部署功能,可一次安裝多台設備,大幅提升運維效率。

工作編程與 AI/HPC 負載管理
GPM 支援 Kubernetes、Slurm 等叢集應用的管理與部署,提供彈性資源調度,可根據需求滾動式分配運算資源,具備高擴展性,以適應 AI 與 HPC 動態的工作負載執行環境需求。

靈活管控大型叢集
GPM 透過一目了然的「機房-機列-機櫃」全方位層級檢視,搭配高度自動化的大規模設備探索技術,徹底顛覆傳統維運模式。無論是初期數百個節點,還是擴張至數千個節點的超級叢集,GPM 都能確保部署與管理工作保持一致的簡單與直覺。讓您的 IT 團隊擺脫繁瑣設定,靈活因應資料中心的無限擴充。

即時監控與智能警示
GPM 提供資訊充足的監控面板,從硬體設備到應用層級,讓管理者一目了然掌握系統效能: 透過智慧警示機制可設定閾值,透過不同的通知管道警示用戶,透過事件管理記錄、分類並快速處理系統問題,主動排除問題降低突發狀況影響,確保高可用性。

快速定位問題
GPM 提供全面的集中化監控平台,能即時彙整所有硬體事件與設備的整體健康狀態。管理團隊無需再耗時逐台登入伺服器檢查,透過單一介面即可快速且精準地掌握異常來源。協助管理者在問題發生的第一時間鎖定根源,大幅縮短反應時間並加速故障排除流程,確保基礎架構的高可用性。

開放式運算環境,靈活整合 MLOps 平台
GPM 提供靈活的叢集與工作負載管理,並支援多種軟體平台,讓企業能夠依自身營運需求進行最佳化資源配置。相容 GIGABYTE AI Platform (GAIP),並支援 NVIDIA AI Enterprise,讓 AI 訓練與推理流程更順暢。
直覺化 UI 與全方位管理工具
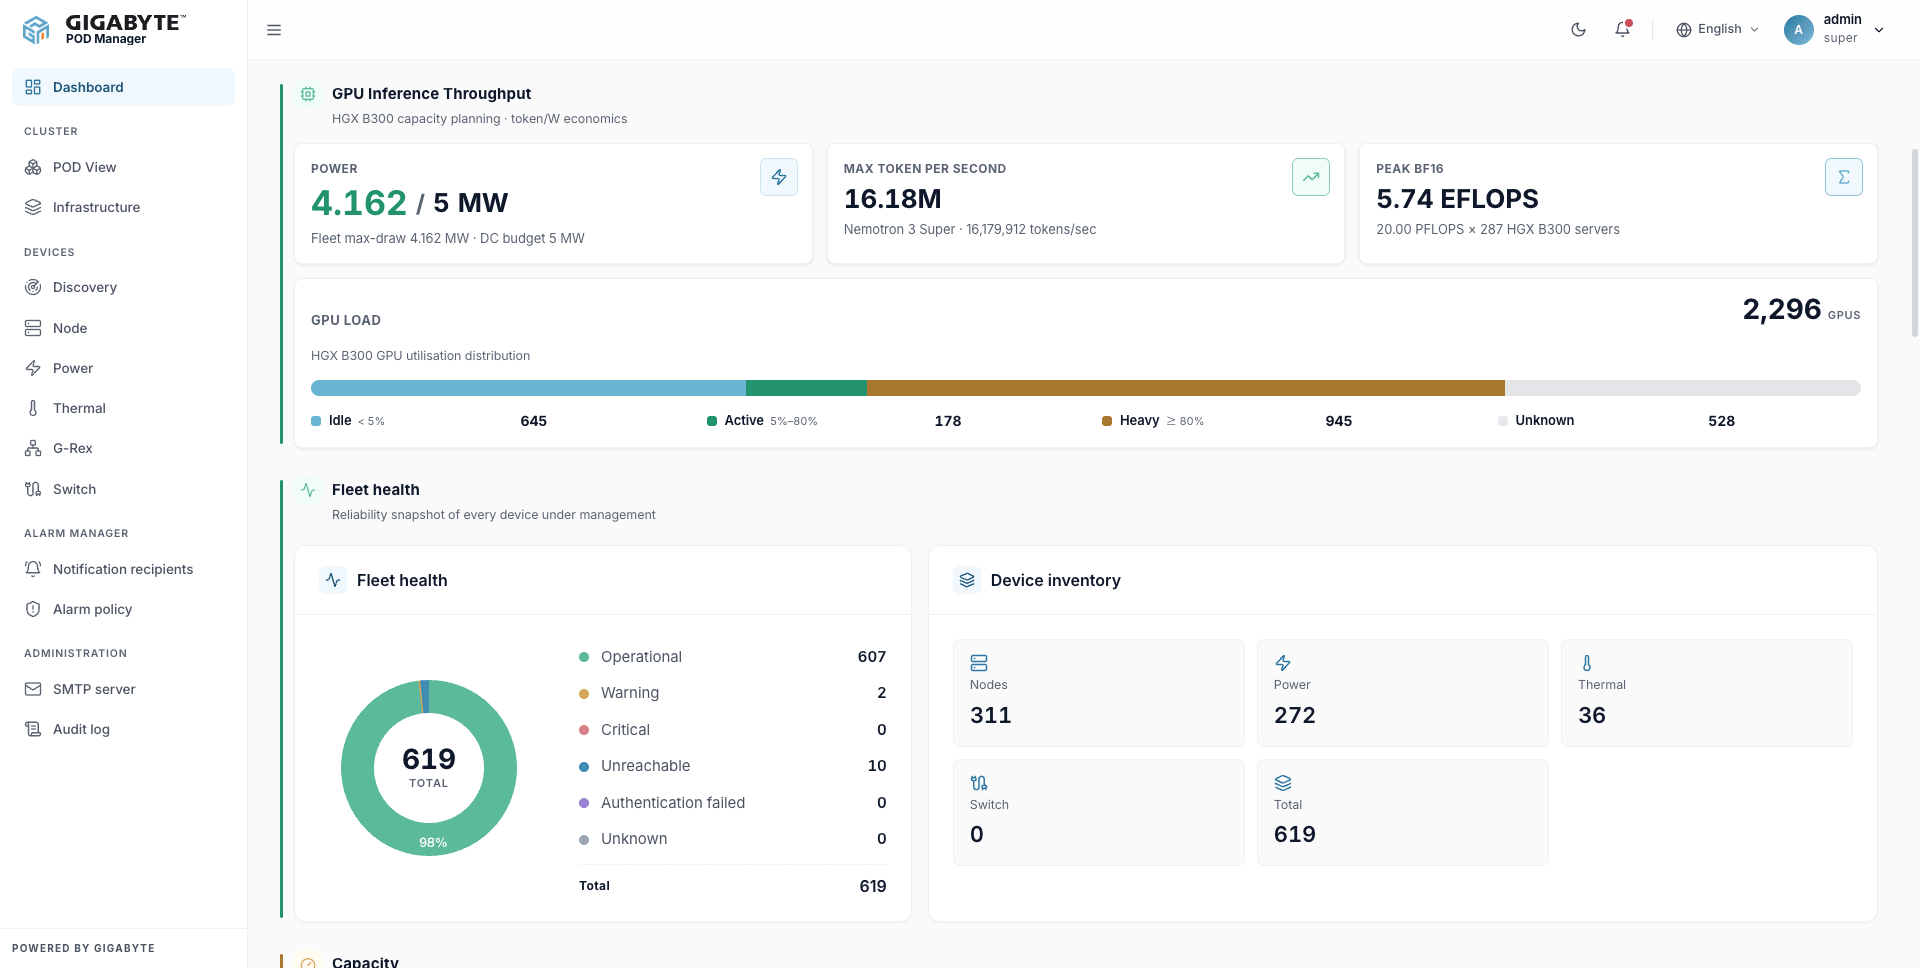
AI 基礎設施總覽儀表板
將 GPU 使用率、功耗、Token Throughput、運算容量與設備健康度整合於單一 Dashboard,從硬體資產進一步掌握 AI Infrastructure 的營運效率。
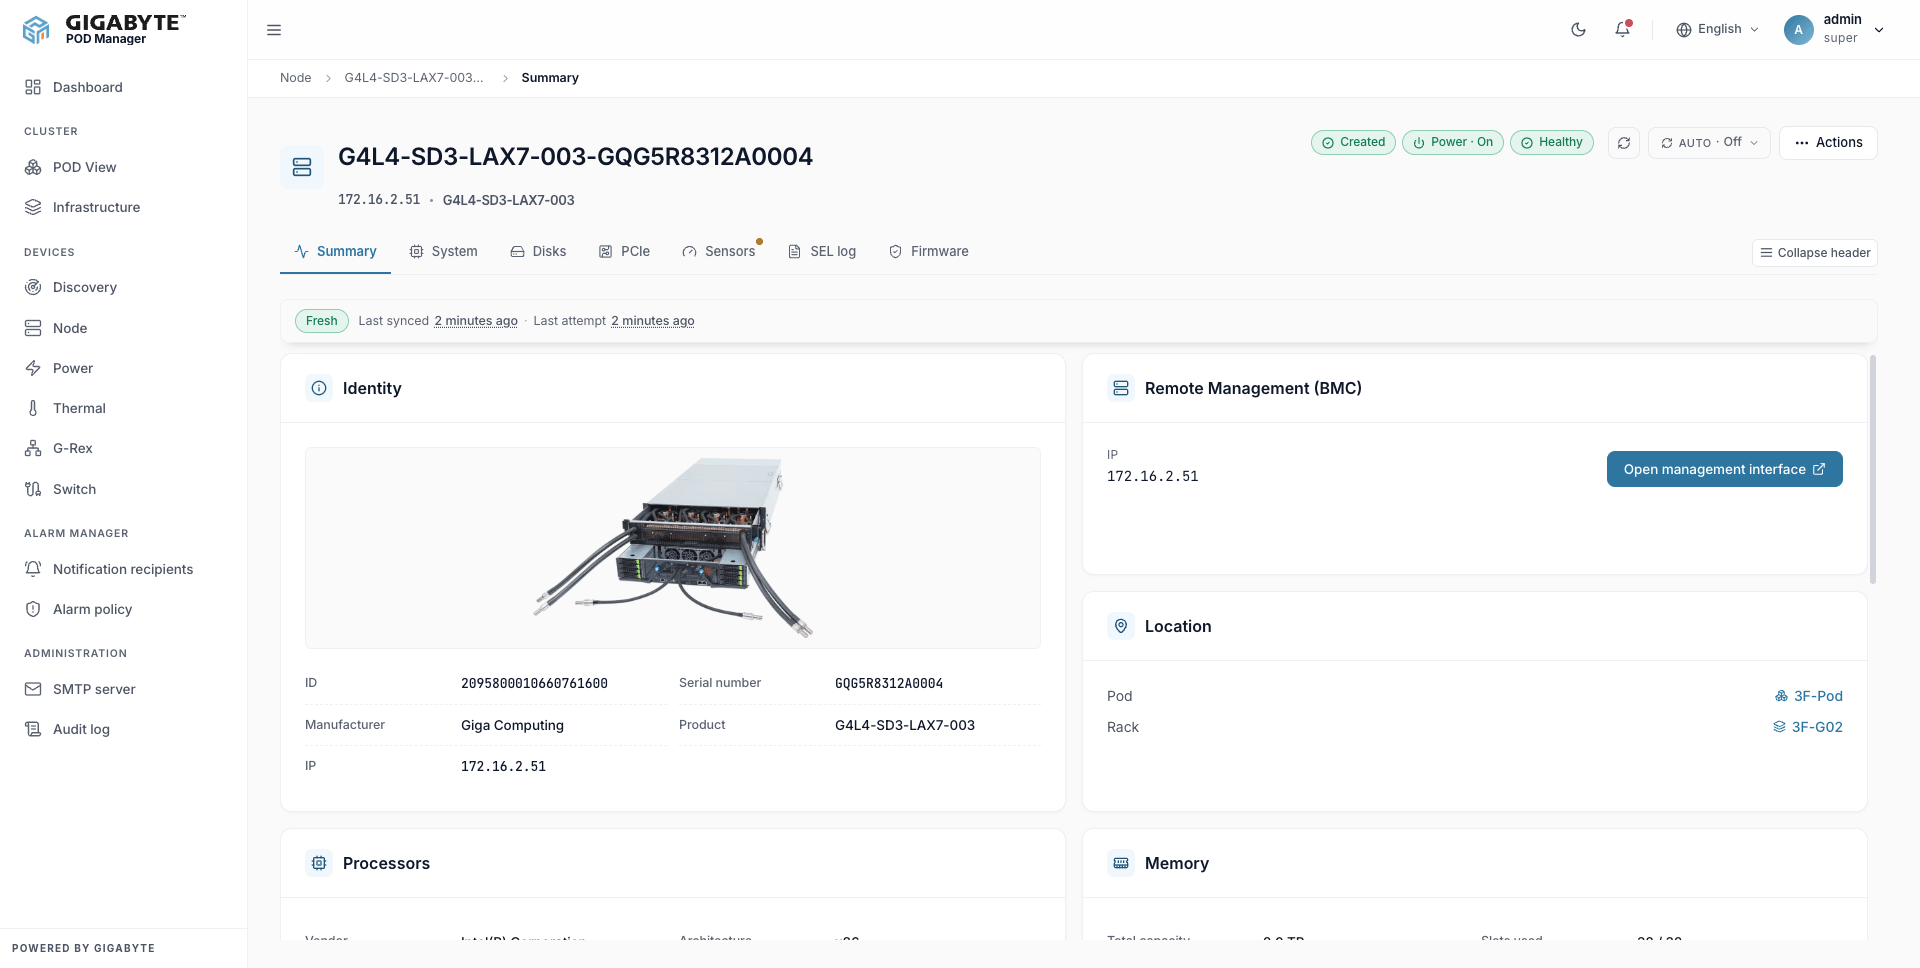
統一伺服器管理
整合硬體規格、BMC、IP、設備健康與實體位置資訊,建立完整且可追蹤的伺服器 Digital Inventory。
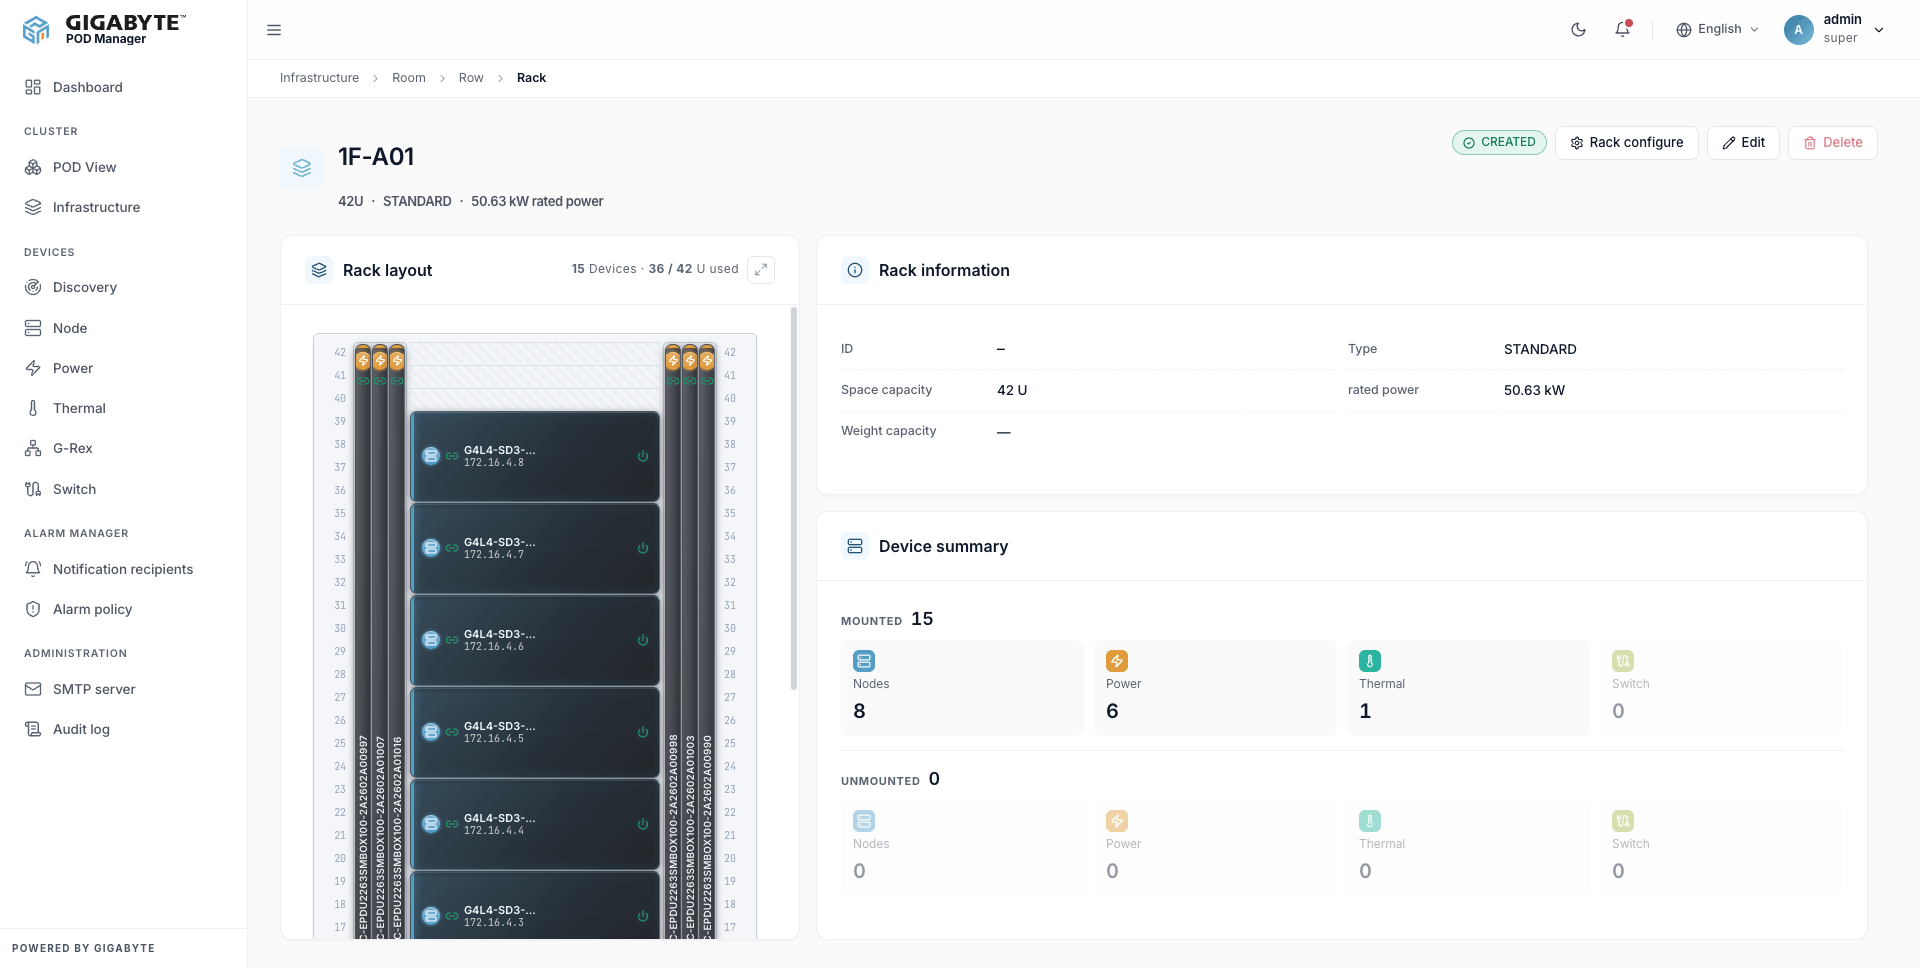
視覺化基礎設施管理
將 Room、Row、Rack 與實體設備整合於單一視圖,快速掌握設備位置、空間使用、功率容量與基礎設施配置。
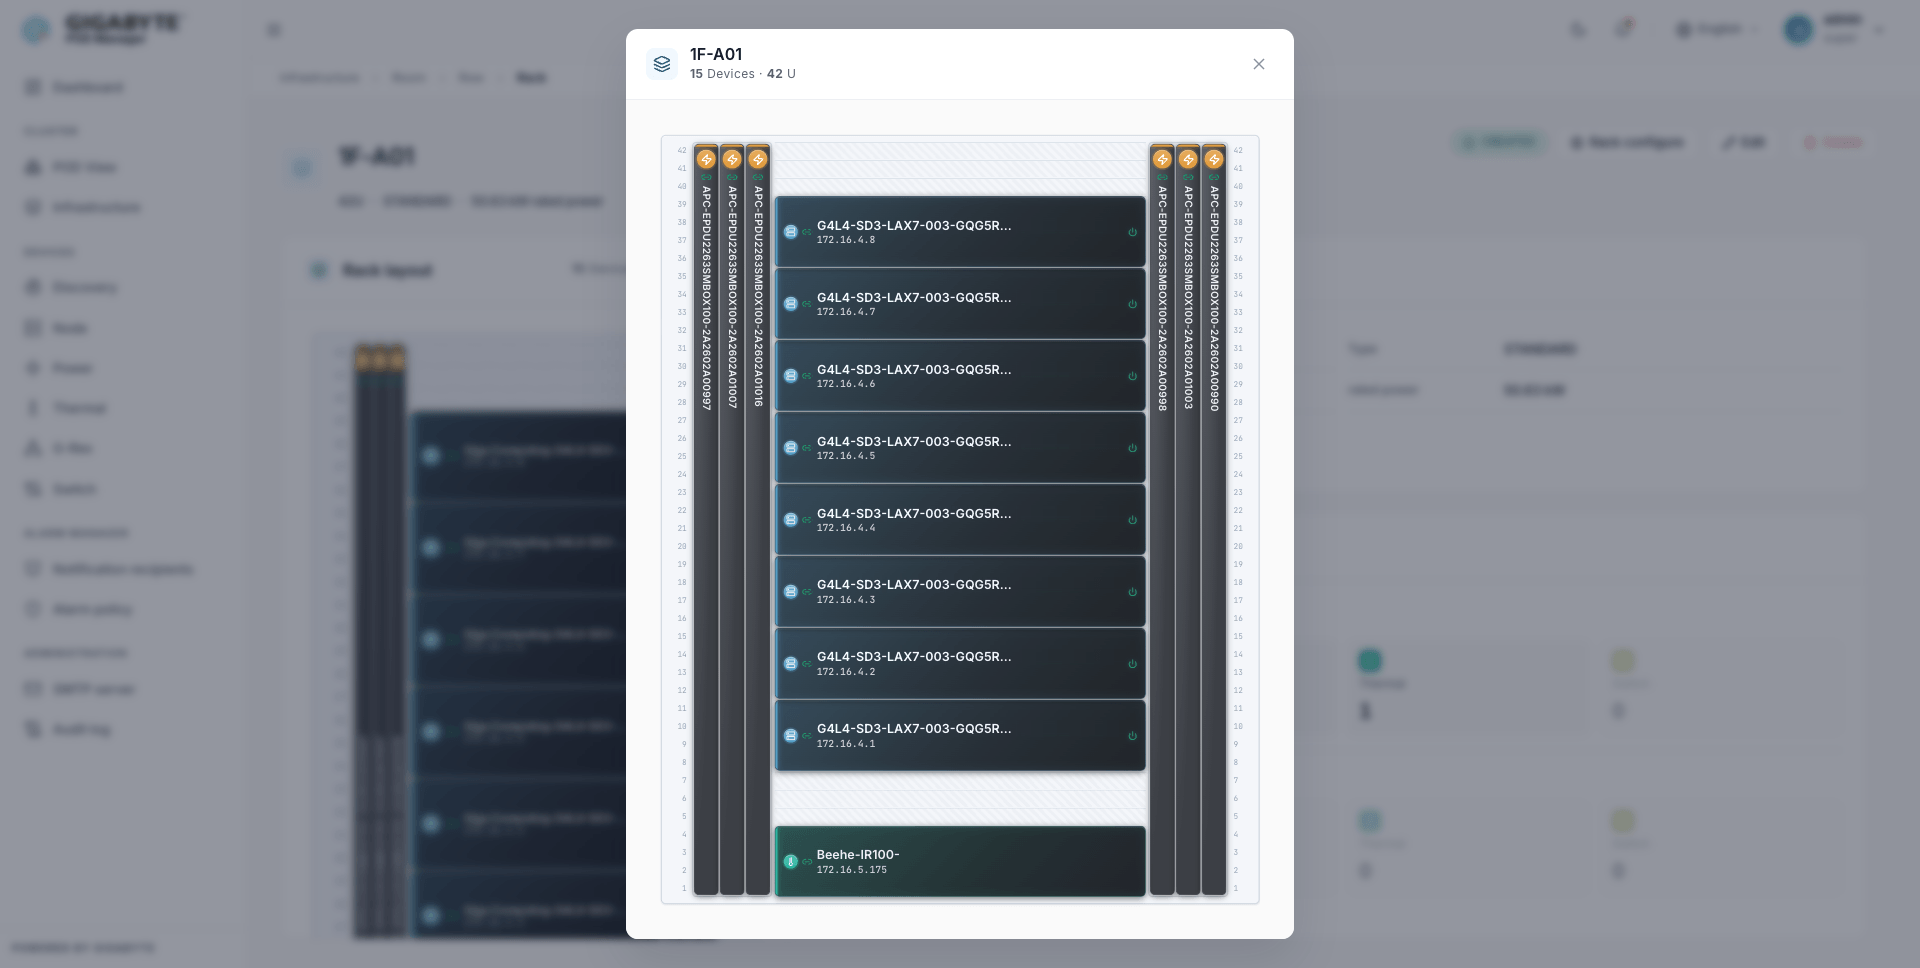
互動式機櫃視覺化
以實際 Rack U 位呈現伺服器、電力與散熱設備,讓設備定位、資產盤點與故障排查更加快速直覺。
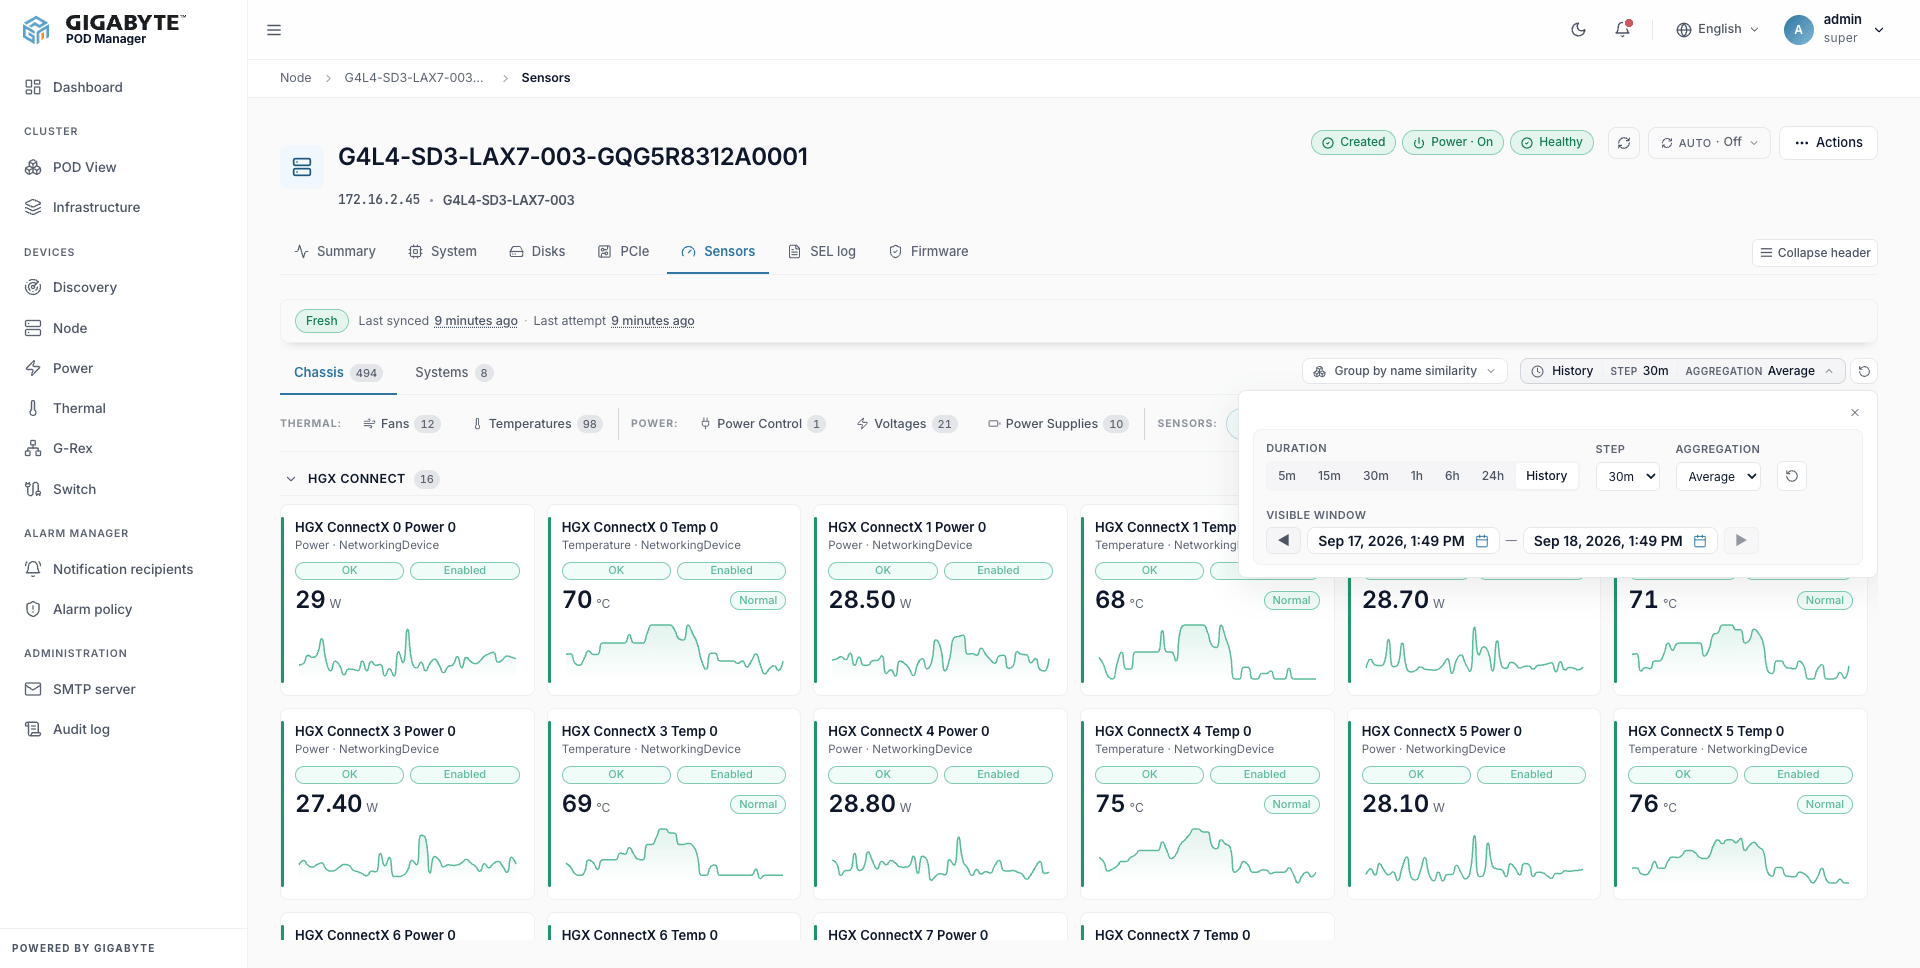
深度硬體遙測
深入 BMC 與硬體 Sensor,持續監控 GPU、溫度、功耗、風扇、電壓與電源供應,完整掌握 AI 基礎設施運行狀態。
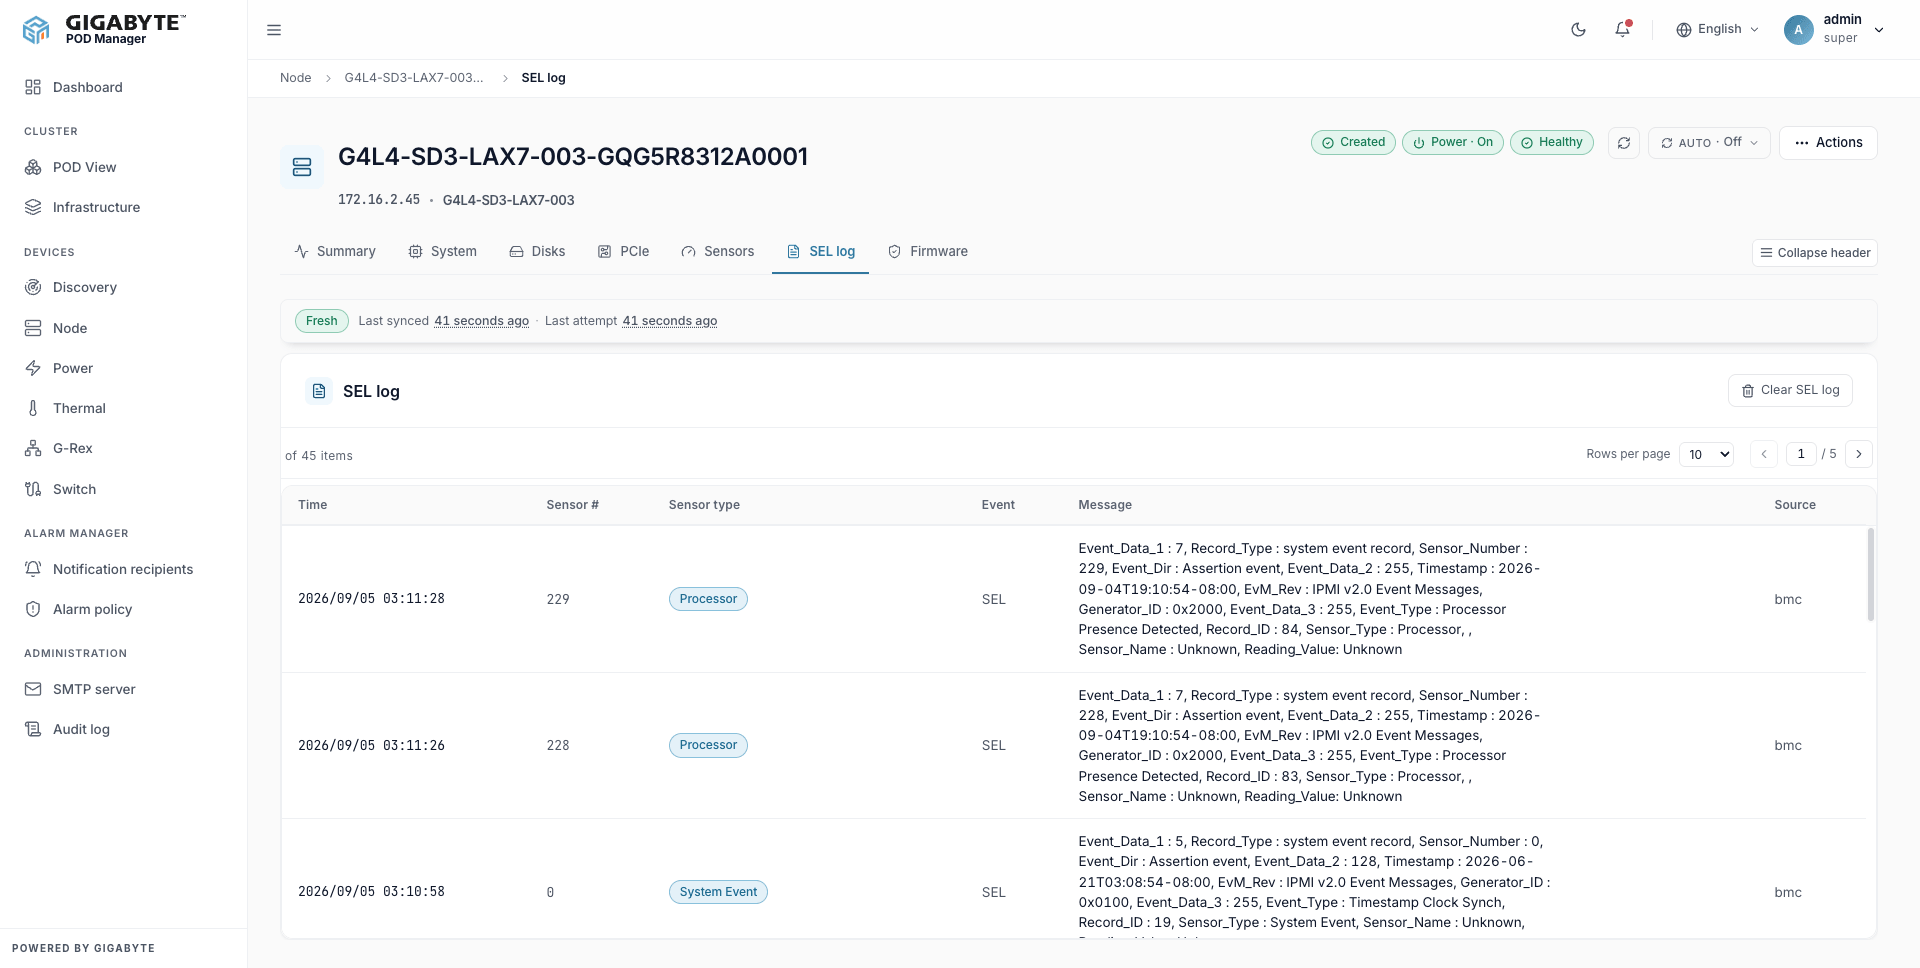
硬體事件診斷
集中管理 BMC SEL 硬體事件,不需逐台登入設備,即可追蹤異常來源與事件歷程,加速問題診斷。
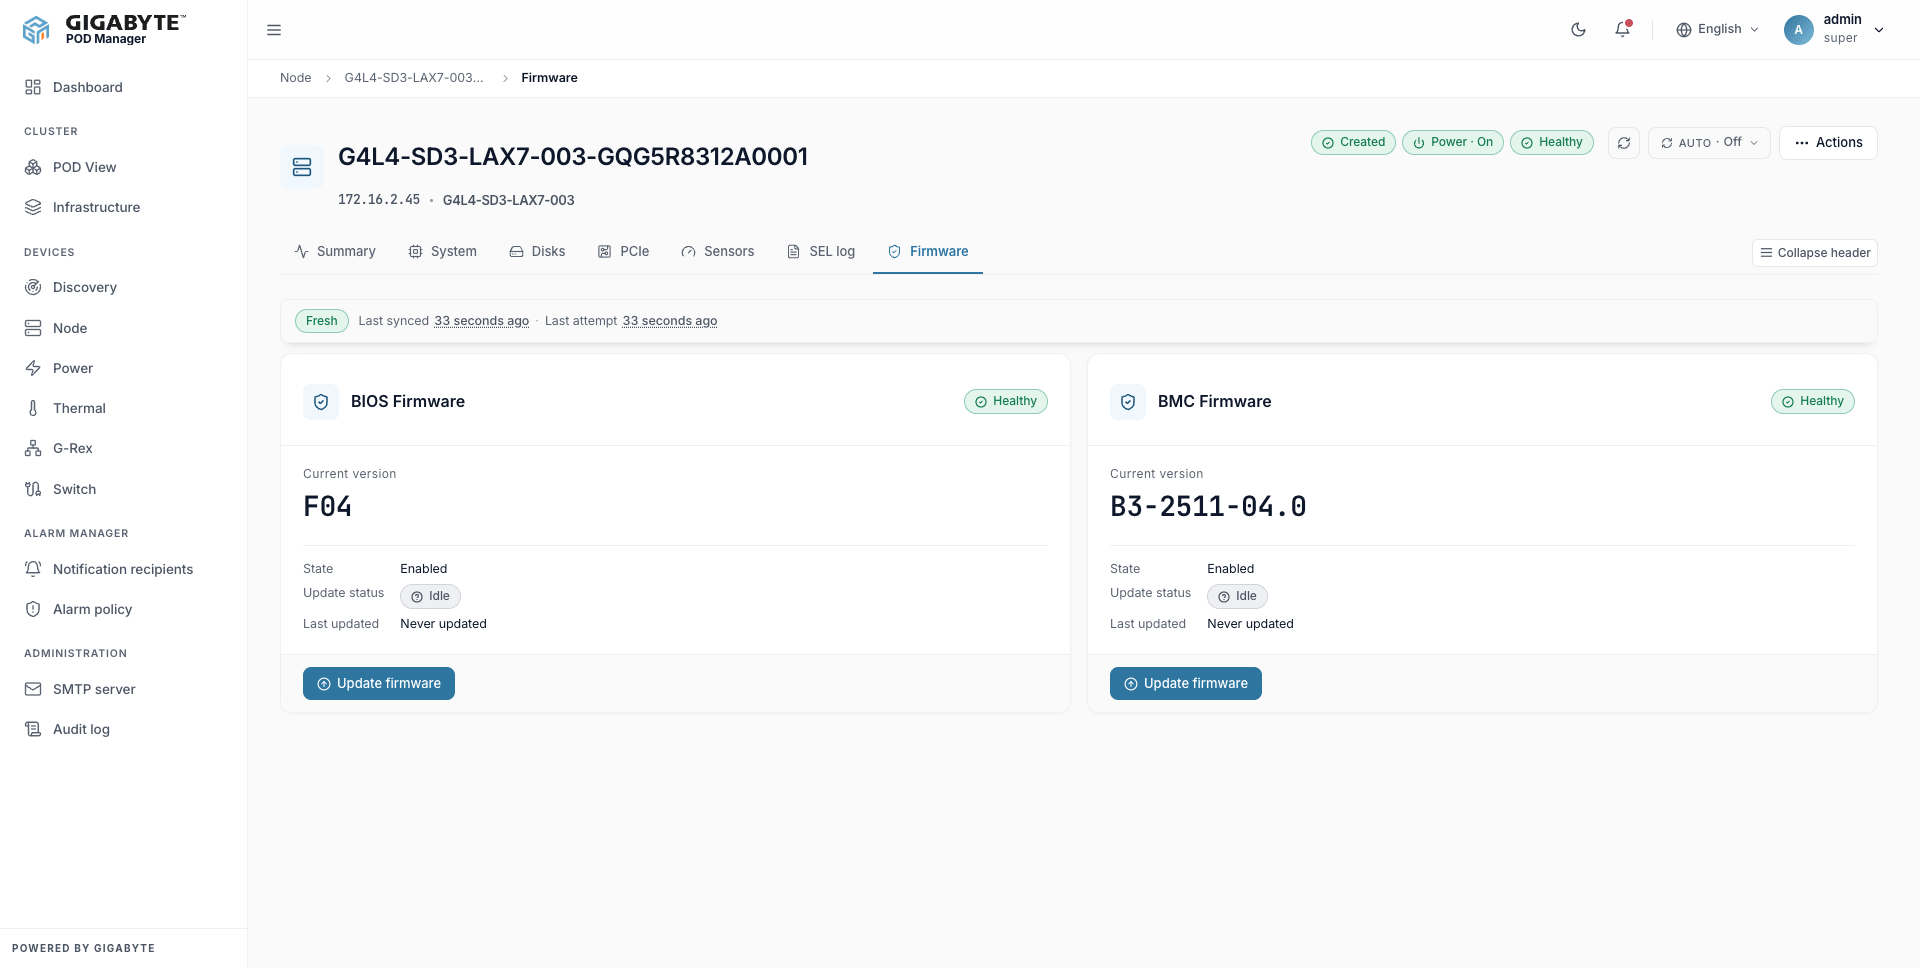
韌體生命週期管理
集中掌握 BIOS 與 BMC 韌體版本及更新狀態,簡化大規模伺服器的 Firmware Baseline 與生命週期管理。
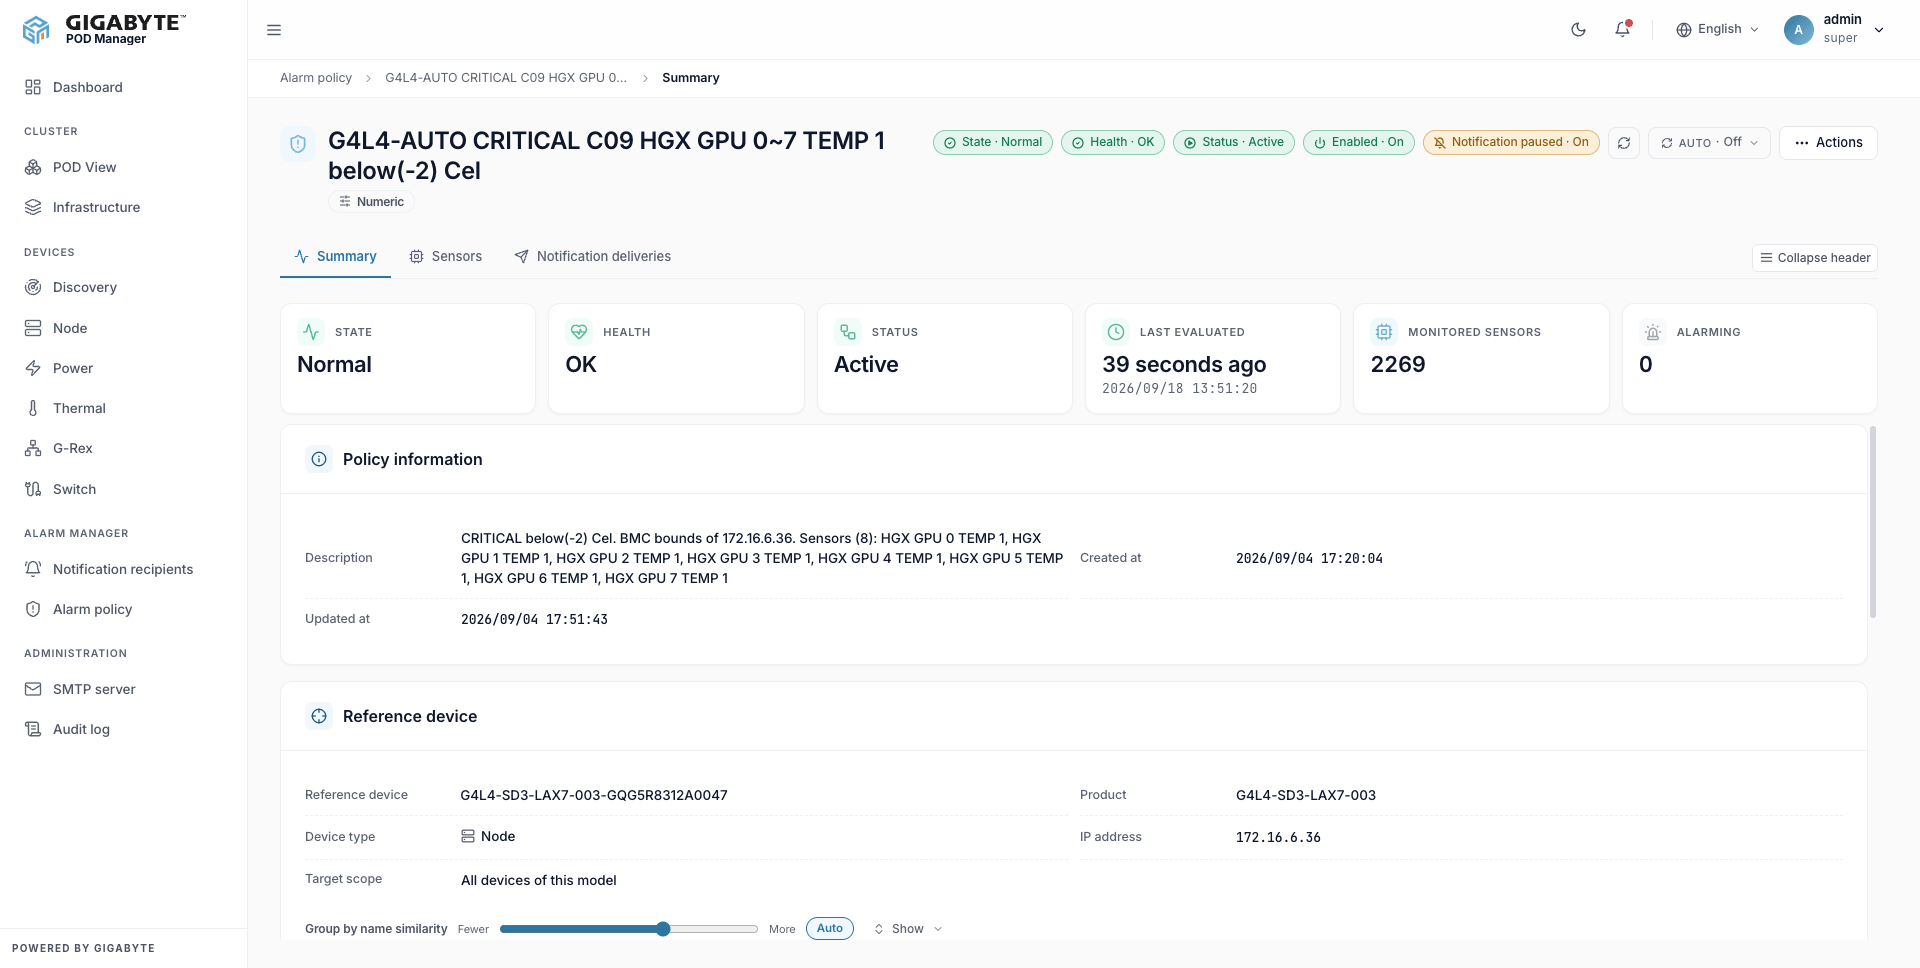
智能告警管理
透過設備模型與 Sensor Group 統一套用監控及告警策略,讓大型 GPU Cluster 的監控規則保持一致且易於管理。此模組由 Alarm Policy (設定各元件告警閾值) 與 Notification Recipients (設定收件人與 Email / Webhook / 聊天系統通知管道) 兩大元件構成,提供完整的告警設定與通知流程。
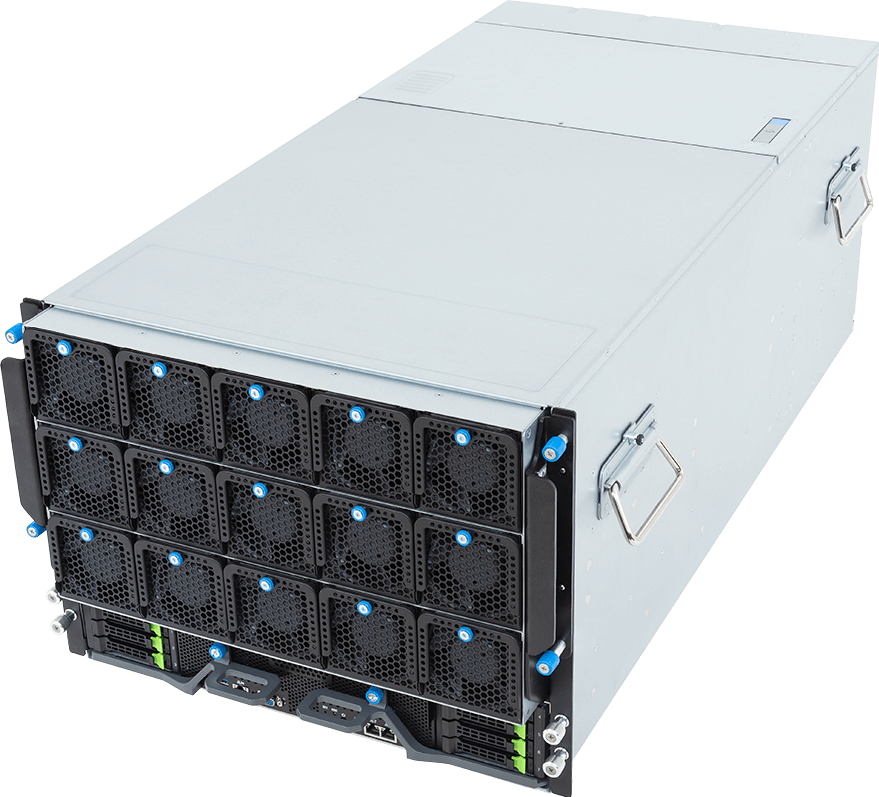
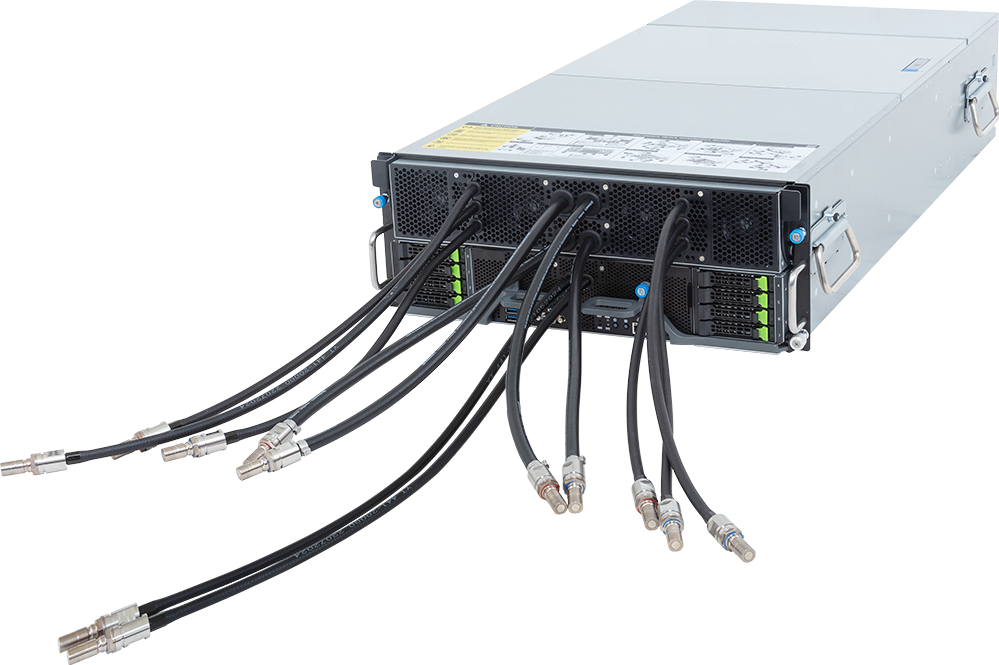
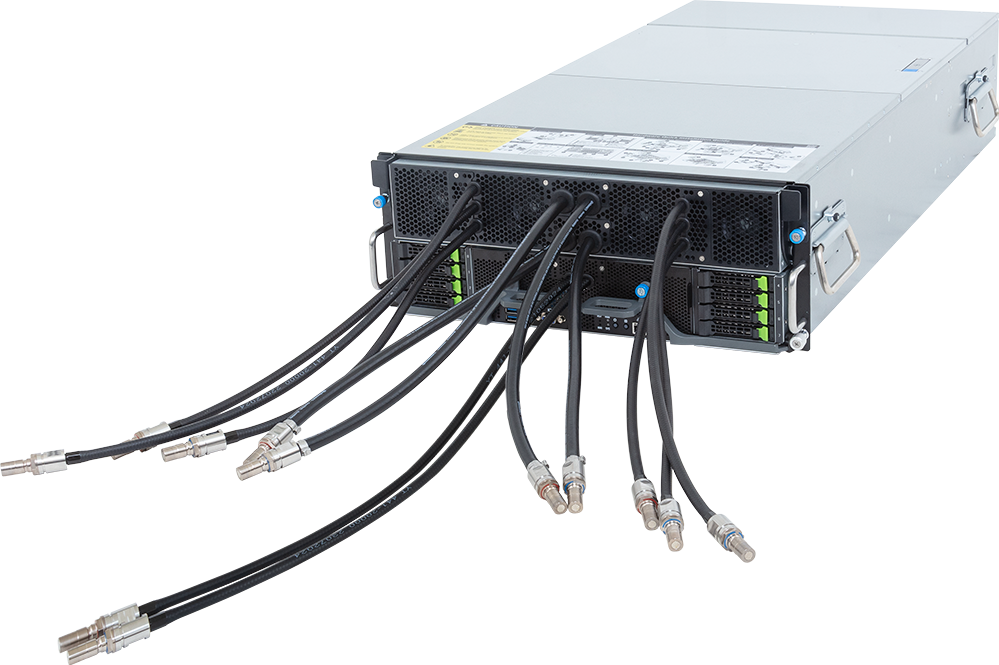
專為 POD 優化的產品

更多資訊
GIGABYTE POD Manager - Streamlined POD Monitoring & Automation
觀看影片

GIGAPOD: The Future of AI Computing in Data Centers
觀看影片
GIGAPOD, the Turnkey AI Supercomputing Solution
觀看影片