AI Training
ما هو؟
يستطيع الذكاء الاصطناعي (AI) الحديث تنفيذ مجموعة متنوعة من المهام، بدءًا من إنشاء النصوص والصور ووصولًا إلى قيادة سيارة ذاتية القيادة، لأنه يُطوَّر من خلال عملية تُعرف باسم تعلُّم الآلة أو التعلُّم العميق. ويتكوّن التعلُّم من عنصرين أساسيين هما «التدريب» و«الاستدلال».
أثناء التدريب، تُدخَل كمية هائلة من البيانات إلى نموذج الذكاء الاصطناعي. وتكون البيانات مُصنَّفة عادةً، مع وجود مبرمجين بشريين للإشراف على العملية، رغم أن أنظمة الذكاء الاصطناعي الأكثر تقدمًا قادرة على إجراء تدريب ذاتي الإشراف أو شبه ذاتي الإشراف باستخدام بيانات غير مُصنَّفة. يحلل الذكاء الاصطناعي المدخلات ويحاول إنتاج المخرجات المتوقعة؛ فعلى سبيل المثال، سيحاول تمييز صور الكلاب من بين عدد هائل من صور الحيوانات. واستنادًا إلى صحة المخرجات، أي إلى ما إذا كانت التوقعات صحيحة أم لا، يُعدّل الذكاء الاصطناعي آلية اتخاذ القرار لديه من خلال إسناد درجات ترجيح إلى معلمات البيانات، تُسمّى أيضًا «الانحيازات».
ومن خلال التكرار المتواصل لعمليات التنبؤ (الانتشار الأمامي) والتغذية الراجعة (الانتشار الخلفي)، تصبح أوزان الترجيح دقيقة إلى حد يضمن اختيار الارتباطات الصحيحة دائمًا. وهكذا يُدرَّب الذكاء الاصطناعي على التعرّف على البيانات التي صُمّم للتعامل معها.
لماذا تحتاج إليه؟
إلى جانب الاستدلال، يُعد تدريب الذكاء الاصطناعي جزءًا أساسيًا لا ينفصل عن الطريقة التي «يتعلم» بها الذكاء الاصطناعي الحديث. فبدلًا من توقّع أن يكتب المبرمجون تعليمات برمجية لكل حالة محتملة، يدرّب الذكاء الاصطناعي نفسه من خلال دراسة كم هائل من البيانات الضخمة، إلى أن يصبح جاهزًا للتعامل مع بيانات جديدة غير معنونة في سيناريو واقعي.
لنستخدم الرؤية الحاسوبية في تطبيقها على التعرف على لوحات أرقام المركبات مثالًا على ذلك. يجب أن تتمكن محطات تحصيل الرسوم الإلكترونية على الطريق السريع من قراءة الحروف والأرقام الموجودة على لوحات المركبات العابرة. وقد تستخدم اللوحات المختلفة خطوطًا متنوعة، كما قد تكون اللوحة نفسها مائلة أو معوجة أو غير واضحة، وقد تتحرك المركبات بسرعات مختلفة. والسبب الوحيد الذي يمكّن الذكاء الاصطناعي من قراءة المعلومات بشكل صحيح في كل مرة هو أنه تدرّب على كمية هائلة من البيانات، ما يتيح له تفسير المدخلات بدقة.
كيف تساعد GIGABYTE؟
إن حجم البيانات الرقمية وموارد الحوسبة اللازمة لتدريب الذكاء الاصطناعي لا يثير الإعجاب فحسب، بل يتزايد أيضًا بشكل أُسّي. ولذلك، أصبح استخدام بنية تحتية للذكاء الاصطناعي مزودة بتسريع GPU والحوسبة المتوازية أمرًا ضروريًا، لا سيما في ظل تسابق المطورين المنافسين أيضًا لطرح منتجات الذكاء الاصطناعي الخاصة بهم في السوق.
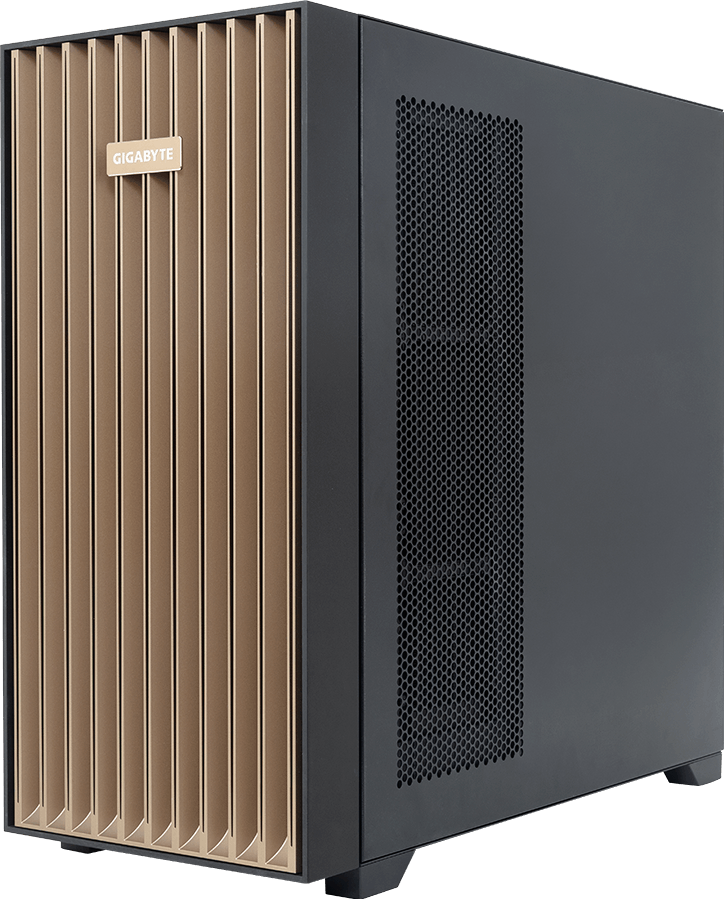
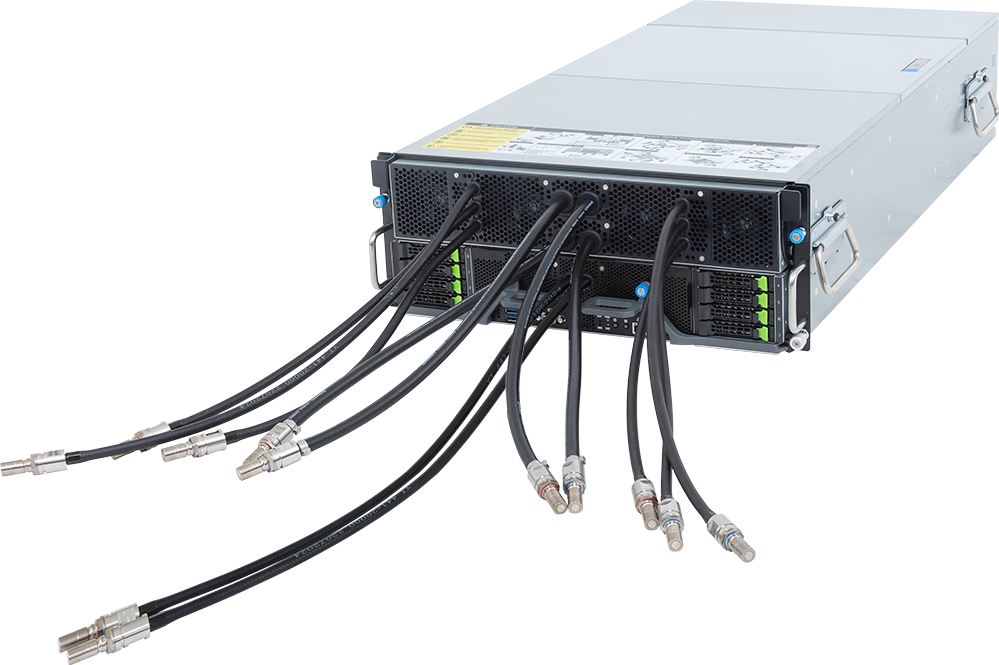
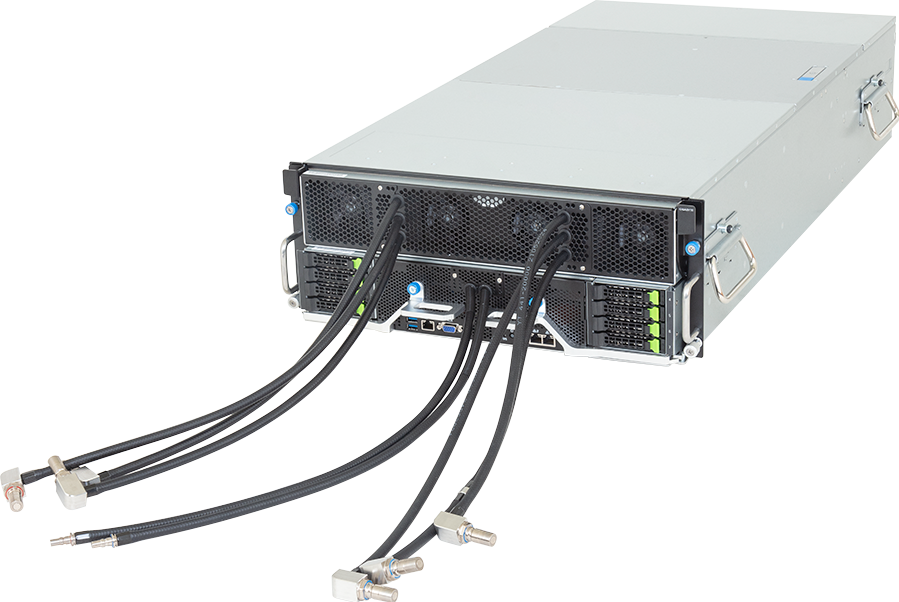
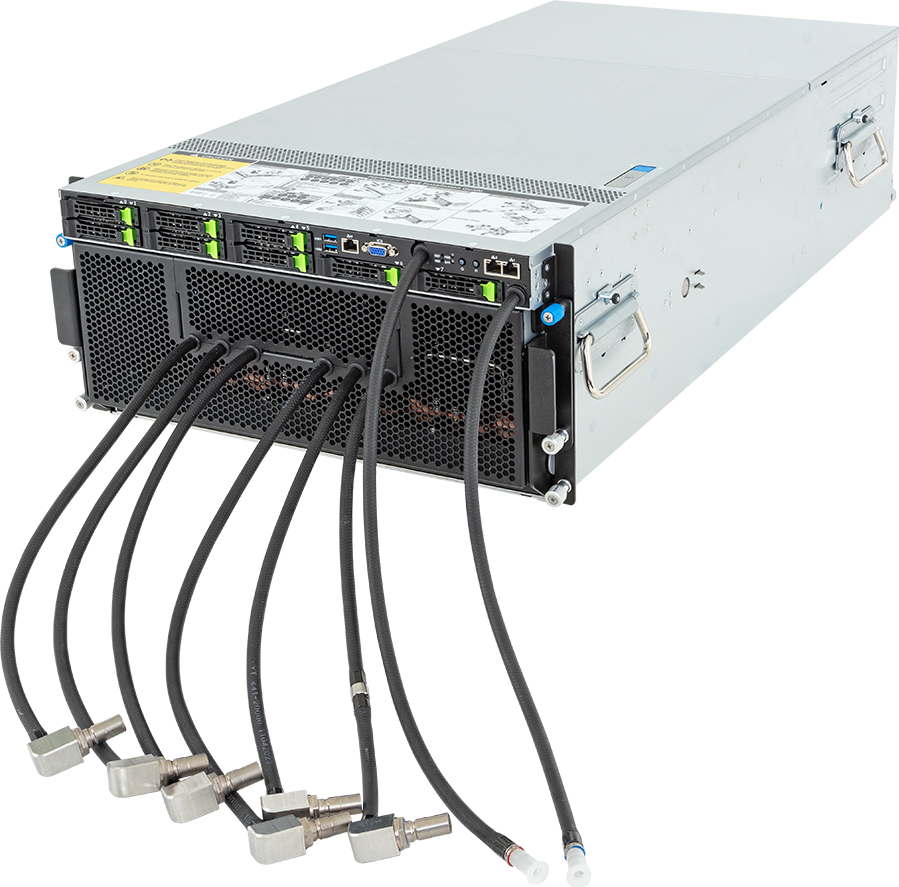
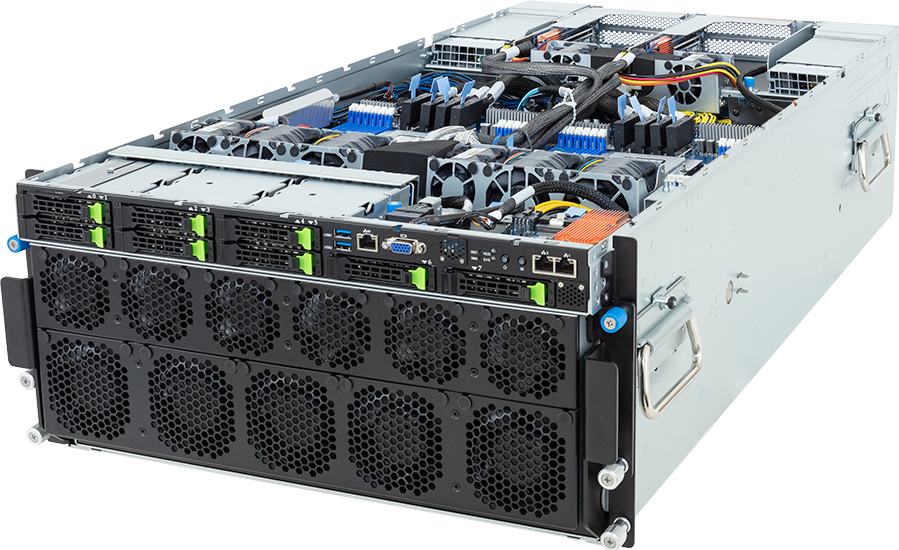
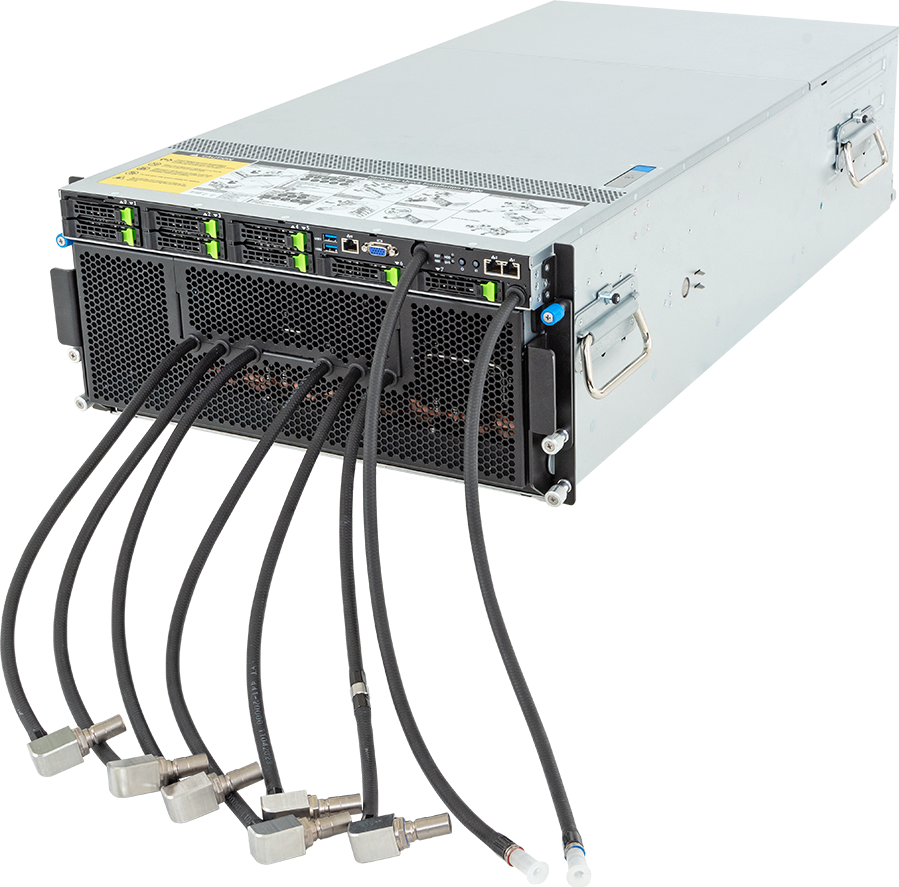
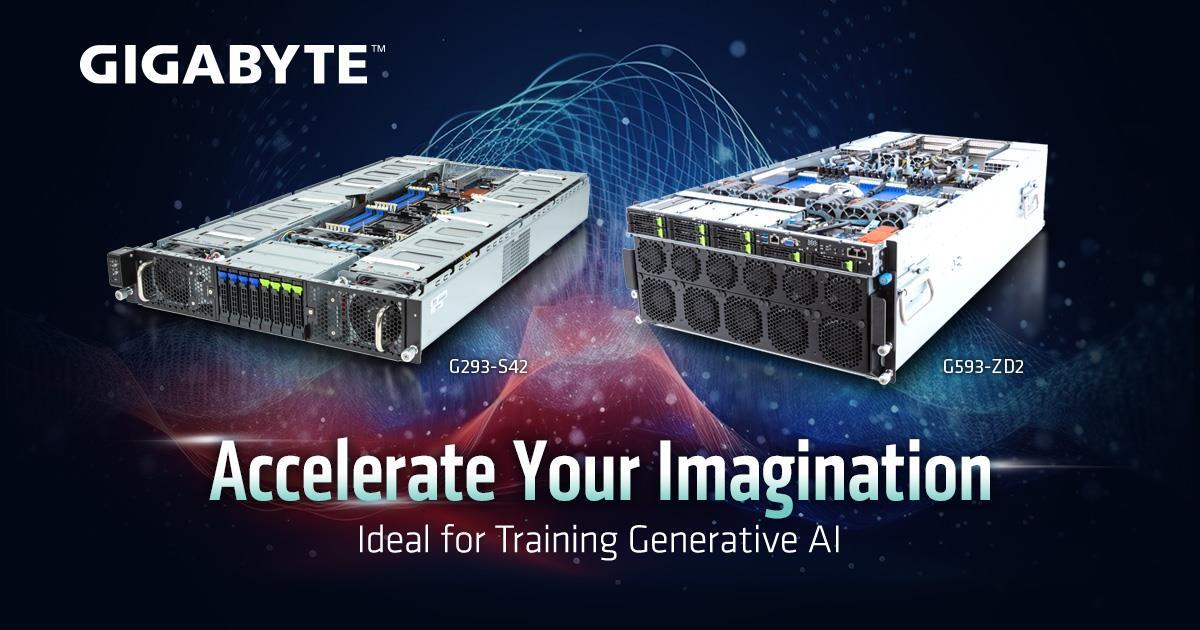
تُعد خوادم G-Series GPU من GIGABYTE Technology من أقوى خوادم الذكاء الاصطناعي في القطاع. وعلى وجه الخصوص، تجمع خوادم G593-SD0 وG593-ZD2 بين وحدة الحوسبة NVIDIA HGX™ H100 المزودة بـ 8 وحدات GPU ومعالجات Intel® Xeon® Scalable من الجيل الرابع أو AMD EPYC™ 9004، على التوالي. وتوفر هذه الخوادم أداءً حاسوبيًا للذكاء الاصطناعي يتجاوز 32 بيتافلوب، ما يجعلها مناسبة بشكل طبيعي لتطبيقات معالجة اللغة الطبيعية (NLP) ونماذج اللغة الكبيرة (LLM). ويمكن احتواء هذه القدرات الهائلة للحوسبة الفائقة داخل خادم بارتفاع 5U، بفضل تقنيات التبريد وتصميم الهيكل المملوكة لشركة GIGABYTE، مما يساعد على تحسين كثافة الحوسبة.
إضافةً إلى أحدث أجهزة الخوادم، توصي GIGABYTE أيضًا باستخدام نظام Myelintek MLSteam لتدريب الشبكات العصبية العميقة، وهو جزء من حل GIGABYTE المتكامل لتدريب الشبكات العصبية العميقة (DNN). وتُعد هذه المنصة الجاهزة لتدريب الشبكات العصبية العميقة بيئةً محمّلة مسبقًا، وموثّقة، ومحسّنة، وتضم عددًا من أشهر أطر ومكتبات التعلم العميق. كما تعتمد هذه المنصة في جانبها الخلفي على خادم G-Series GPU.
لمزيد من المعلومات: 《طوّر الذكاء الاصطناعي مع حلول خوادم الذكاء الاصطناعي فائقة الأداء من GIGABYTE》
تُعد خوادم G-Series GPU من GIGABYTE Technology من أقوى خوادم الذكاء الاصطناعي في القطاع. وعلى وجه الخصوص، تجمع خوادم G593-SD0 وG593-ZD2 بين وحدة الحوسبة NVIDIA HGX™ H100 المزودة بـ 8 وحدات GPU ومعالجات Intel® Xeon® Scalable من الجيل الرابع أو AMD EPYC™ 9004، على التوالي. وتوفر هذه الخوادم أداءً حاسوبيًا للذكاء الاصطناعي يتجاوز 32 بيتافلوب، ما يجعلها مناسبة بشكل طبيعي لتطبيقات معالجة اللغة الطبيعية (NLP) ونماذج اللغة الكبيرة (LLM). ويمكن احتواء هذه القدرات الهائلة للحوسبة الفائقة داخل خادم بارتفاع 5U، بفضل تقنيات التبريد وتصميم الهيكل المملوكة لشركة GIGABYTE، مما يساعد على تحسين كثافة الحوسبة.
إضافةً إلى أحدث أجهزة الخوادم، توصي GIGABYTE أيضًا باستخدام نظام Myelintek MLSteam لتدريب الشبكات العصبية العميقة، وهو جزء من حل GIGABYTE المتكامل لتدريب الشبكات العصبية العميقة (DNN). وتُعد هذه المنصة الجاهزة لتدريب الشبكات العصبية العميقة بيئةً محمّلة مسبقًا، وموثّقة، ومحسّنة، وتضم عددًا من أشهر أطر ومكتبات التعلم العميق. كما تعتمد هذه المنصة في جانبها الخلفي على خادم G-Series GPU.
لمزيد من المعلومات: 《طوّر الذكاء الاصطناعي مع حلول خوادم الذكاء الاصطناعي فائقة الأداء من GIGABYTE》