LLM (Large Language Model)
Qu’est-ce qu’un grand modèle de langage (LLM)?
Un grand modèle de langage (LLM) est un modèle d’intelligence artificielle (IA) capable de comprendre le langage humain sans programmation supplémentaire et de générer du texte pratiquement indiscernable d’un texte rédigé par une personne, grâce à un procédé appelé traitement automatique du langage naturel (TALN). Parmi les LLM populaires sur le marché, on trouve la gamme GPT d’OpenAI, la famille LLaMA de Meta et le modèle libre BLOOM. De nombreux services d’IA générative reposant sur le langage ont été créés à partir de LLM, notamment ChatGPT d’OpenAI, Bard de Google et Bing Chat de Microsoft.
À la base, un LLM est un réseau neuronal artificiel (RNA) qui utilise un type d’architecture d’apprentissage profond appelé « transformateur ». Le mécanisme de calcul parallèle du transformateur lui permet d’effectuer un entraînement de l’IA à partir d’un volume considérable de données textuelles — comme l’ensemble de Wikipédia — et de paramètres de données se comptant en milliards, voire en milliers de milliards. Pendant l’entraînement, le modèle d’IA tente de prédire la réponse appropriée à une entrée donnée — par exemple, le mot suivant d’une phrase ou la réponse adéquate à une question —, puis vérifie ses résultats. Selon que sa prédiction est correcte ou non, le modèle d’IA ajuste les « biais » ou les « poids » de ses paramètres de données, jusqu’à ce qu’il génère presque toujours le résultat attendu. C’est pourquoi les services d’IA fondés sur des LLM peuvent comprendre le langage humain et y répondre avec aisance. Dans la vie courante, on peut notamment citer un robot conversationnel de soutien à la clientèle qui fournit des réponses exactes à des plaintes comportant des fautes d’orthographe ou de grammaire, ainsi que ChatGPT, qui compose des poèmes et des CV en quelques secondes.
En savoir plus : Qu’est-ce que le RAG et comment fonctionne-t-il?
Quelles sont les applications des grands modèles de langage?
Sans les grands modèles de langage, il faudrait utiliser des invites (vous vous souvenez de MS-DOS?) ou une interface utilisateur graphique (GUI) conçue à l’avance pour communiquer avec un ordinateur. S’attendre à ce que l’ordinateur réponde en langage naturel relèverait de la science-fiction. Grâce à la généralisation des grands modèles de langage, de nombreux nouveaux services fondés sur l’IA sont désormais accessibles:
● Moteurs de recherche et chatbots: la technologie des grands modèles de langage a doté ces fonctions populaires de capacités d’IA. Les moteurs de recherche et les chatbots peuvent non seulement comprendre nos requêtes avec une précision remarquable, mais ces fonctionnalités ont également donné naissance à une nouvelle génération d’ordinateurs et d’appareils personnels optimisés par l’IA.
● IA générative: des outils comme ChatGPT peuvent aussi bien résumer et traduire des documents que créer du contenu entièrement nouveau, comme des lettres et des scénarios télévisés.
● Soins de santé et médecine: les applications de soins de santé intelligentes fondées sur les grands modèles de langage peuvent générer des dossiers médicaux électroniques (DME), ce qui allégera le fardeau administratif du personnel médical et permettra de créer des bases de données destinées à l’analyse des données de santé.
● Programmation et développement de l’IA: GitHub Copilot, développé par Microsoft et OpenAI, peut écrire du code informatique en JavaScript, en Python et dans d’autres langages de programmation. C’est particulièrement remarquable, car les grands modèles de langage permettent en pratique à l’IA de programmer les futurs outils d’IA.
Comment GIGABYTE peut-elle vous aider?
GIGABYTE Technology offre des solutions matérielles et logicielles pour travailler avec les grands modèles de langage (GML) et les services d’IA générative fondés sur ces modèles.
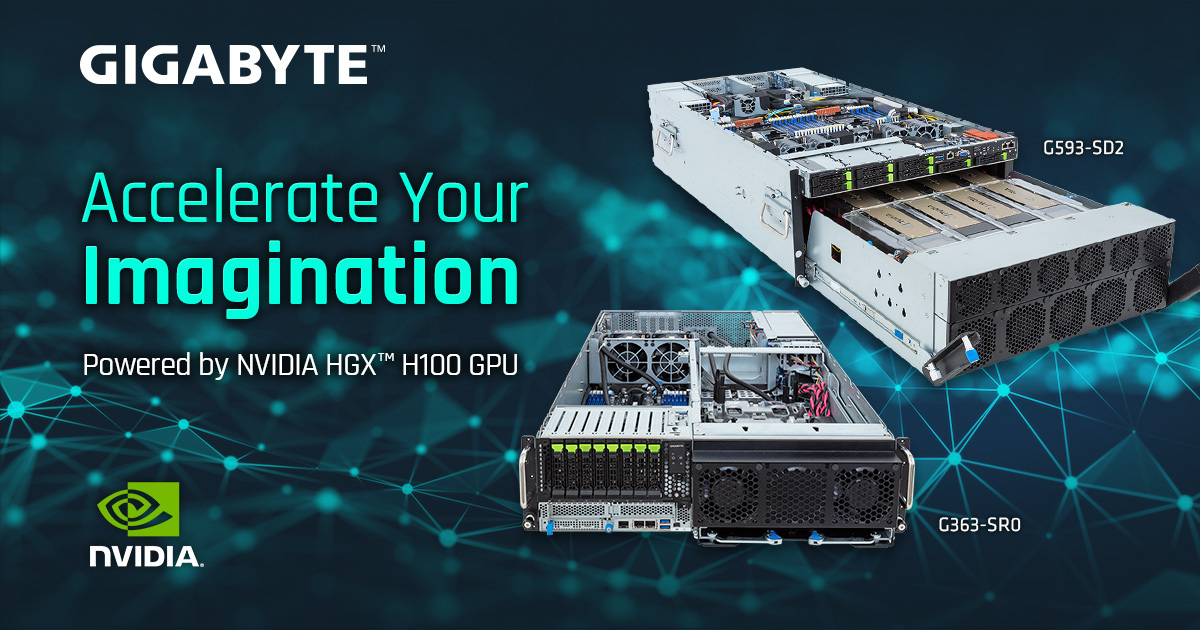
Sur le plan matériel, GIGABYTE propose des serveurs d’IA particulièrement adaptés aux besoins de calcul et de stockage de données liés à l’entraînement des modèles d’IA. Par exemple, le G593-SD0 de GIGABYTE est le premier serveur HGX™ H100 8-GPU SXM5 certifié par NVIDIA sur le marché. Il intègre le module de calcul NVIDIA HGX™ H100 8-GPU, ce qui en fait une plateforme de calcul d’IA extrêmement puissante. D’autres produits de la gamme de serveurs GPU de la série G de GIGABYTE peuvent également être équipés d’accélérateurs GPU avancés, comme le NVIDIA L40S, afin de prendre en charge les charges de travail des grands modèles de langage. Pour le stockage de données, le serveur de stockage de la série S S183-SH0 de GIGABYTE est spécialement conçu pour les grands modèles de langage. Il fournit un stockage sur baie entièrement flash (AFA) grâce au déploiement de disques SSD EDSFF E1.S, qui tirent parti des technologies PCIe Gen5 et NVMe. Le serveur peut ainsi répondre aux exigences élevées en matière de stockage et de récupération rapides des données nécessaires au développement de grands modèles de langage.
Sur le plan logiciel, MyelinTek Inc., une société dans laquelle GIGABYTE détient une participation, propose le système d’entraînement DNN MLSteam, une « plateforme MLOps » prenant en charge les applications de traitement automatique du langage naturel (NLP) et les grands modèles de langage. Le système d’entraînement DNN MLSteam peut optimiser des grands modèles de langage à code source ouvert comme BLOOM pour la plateforme logicielle d’accélération GPU choisie par le client, comme AMD ROCm ou NVIDIA CUDA.