AI Tokens
KI-Token
Was sind KI-Token?
KI-Token sind die grundlegenden Dateneinheiten, die von Modellen der künstlichen Intelligenz verarbeitet werden. Texte, Bilder, Audiodaten und andere Eingabedaten werden durch einen als Tokenisierung bezeichneten Prozess in Tokenfolgen umgewandelt, die ein KI-Modell verarbeiten kann.
In einem Large Language Model (LLM) kann ein Token ein vollständiges Wort, einen Wortteil, ein Satzzeichen oder ein anderes Textfragment darstellen. Ein Token entspricht daher nicht zwangsläufig einem Wort oder einem einzelnen Zeichen. Außerdem verwenden verschiedene Modelle unterschiedliche Tokenizer, sodass derselbe Inhalt zu einer unterschiedlichen Anzahl von Token führen kann.
Wenn ein Benutzer einen Prompt übermittelt, verarbeitet das Modell zunächst die Eingabe-Token und generiert während der Inferenz anschließend Ausgabe-Token. Diese Ausgabe-Token werden in die für den Benutzer sichtbare Antwort umgewandelt.
Warum sind KI-Token wichtig?
Die Token-Anzahl bestimmt, wie viele Daten ein KI-Modell verarbeiten muss, und wird häufig auch zur Messung der Nutzung und der Kosten generativer KI-Dienste herangezogen.
Das Kontextfenster eines LLM wird typischerweise in Token gemessen und bestimmt, wie viele Informationen das Modell gleichzeitig verarbeiten kann. Ein größeres Kontextfenster kann längere Dokumente, Unterhaltungen oder andere Kontextinformationen aufnehmen, erfordert jedoch zusätzliche Rechen- und Speicherressourcen.
Da Reasoning-Modelle und agentische KI längere und komplexere Workflows ausführen, kann eine einzelne Aufgabe deutlich mehr Token umfassen. NVIDIA-CEO Jensen Huang erklärte auf der GTC 2026, dass der Bedarf an KI-Rechenleistung in den vergangenen Jahren um etwa das Eine-Millionenfache gestiegen ist. Google gab im selben Jahr ebenfalls bekannt, dass seine KI-Systeme monatlich mehr als 3,2 Billiarden Token verarbeiten – gegenüber 9,7 Billionen zwei Jahre zuvor. Das entspricht einem Anstieg um mehr als das 300-Fache. Mit dem weiteren Wachstum der Token-Volumina werden Token-Durchsatz, Latenz und Kosten zunehmend zu wichtigen Kennzahlen für die KI-Inferenz.
Wie funktioniert die Tokenisierung?
Bei der Tokenisierung werden Rohdaten in Token umgewandelt, die ein KI-Modell verarbeiten kann. Bei Texten verwendet ein Tokenizer ein modellspezifisches Vokabular und entsprechende Codierungsregeln, um Inhalte in kleinere Einheiten zu unterteilen und jedem Token für die Verarbeitung eine numerische Repräsentation zuzuweisen.
Ein häufig verwendetes Wort kann nur ein Token erfordern, während ein längeres oder weniger häufig verwendetes Wort in mehrere Token aufgeteilt werden kann. Sprache, Interpunktion, Sonderzeichen und das Design des Tokenizers können das Ergebnis beeinflussen. Daher kann derselbe Inhalt bei verschiedenen KI-Modellen zu unterschiedlichen Tokenanzahlen führen.
Multimodale KI-Modelle können auch Bilder, Audiodaten und Videos in Token oder ähnliche Repräsentationen umwandeln, die das Modell verarbeiten kann.
Wie werden KI-Token gezählt und abgerechnet?
Es gibt keine universelle Formel für die Umrechnung von Wörtern oder Zeichen in KI-Token. Die tatsächliche Anzahl hängt vom Tokenizer, der Sprache und dem verwendeten Inhalt des jeweiligen Modells ab.
Generative KI-Dienste unterscheiden in der Regel zwischen Eingabe- und Ausgabetoken. Eingabetoken umfassen Prompts, Dokumente und andere dem Modell bereitgestellte Kontextinformationen. Ausgabetoken werden erzeugt, während das Modell eine Antwort erstellt. Einige Dienste berücksichtigen außerdem möglicherweise gecachte Token. Dabei handelt es sich um wiederverwendbare Eingabeinhalte, die nicht erneut vollständig verarbeitet werden müssen. Auch Reasoning-Token können berücksichtigt werden. Sie werden während des internen Schlussfolgerungsprozesses des Modells vor der Erstellung einer Antwort verwendet. Die spezifischen Tokenkategorien, Zählmethoden und Abrechnungsmodelle unterscheiden sich je nach Anbieter.
Neben der Gesamtzahl der Token wird häufig die Anzahl der Token pro Sekunde zur Messung der Generierungsgeschwindigkeit verwendet. Die Time to First Token (TTFT) misst dagegen die Verzögerung zwischen einer Anfrage und dem ersten generierten Token. Bei KI-Plattformen, die viele Nutzer gleichzeitig bedienen, können diese Kennzahlen sowohl die Nutzererfahrung als auch die Effizienz der Infrastruktur unmittelbar beeinflussen.
Wie unterstützt GIGABYTE?
Mit der Verarbeitung immer größerer Tokenmengen durch generative KI, Reasoning-Modelle undagentische KImuss die Infrastruktur für KI-Inferenz GPU-Beschleunigung und CPU-Berechnungen, Speicherkapazität, Datenbewegungen, Kühlung und Energieeffizienz ausgewogen aufeinander abstimmen.
GPUs eignen sich besonders für hochgradig parallele KI-Inferenz-Workloads wie Large Language Models und multimodale Modelle. CPUs spielen jedoch weiterhin eine wichtige Rolle bei der Datenverarbeitung, bei Anwendungsdiensten, der Modellorchestrierung und bei Workflows agentischer KI. Wenn KI-Agenten Daten abrufen, APIs aufrufen, externe Tools verwenden oder mehrere Aufgaben koordinieren, arbeiten CPU- und GPU-Ressourcen im gesamten KI-System zusammen.
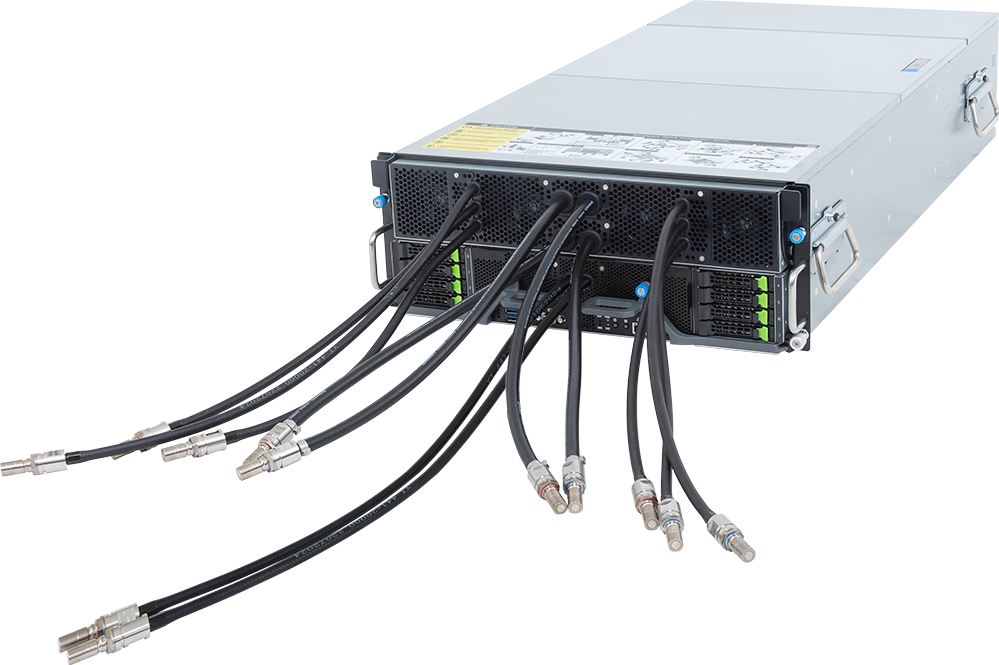
GIGABYTE bietet ein umfassendes Portfolio – von leistungsstarken CPU- und GPU-Servern bis hin zu KI-Computing-Plattformen im Rack-Maßstab – für KI-Inferenz-Workloads unterschiedlichster Art und Größenordnung. MitGIGAPOD,GIGABYTE POD Manager(GPM) und fortschrittlichen Kühltechnologien wie Direct Liquid Cooling unterstützt GIGABYTE Unternehmen beim Aufbau skalierbarer KI-Infrastrukturen für Inferenz mit hohem Durchsatz und niedriger Latenz.