Neocloud
Néocloud
Qu’est-ce qu’un néocloud ?
Un néocloud est un service cloud conçu spécifiquement pour les charges de travail liées à l’intelligence artificielle (IA) et au calcul haute performance (HPC). Contrairement aux plateformes cloud traditionnelles, qui prennent en charge un large éventail d’applications informatiques d’entreprise, les néoclouds accordent une plus grande importance aux ressources de calcul accéléré, telles que les GPU, ainsi qu’aux réseaux haut débit, au stockage haute performance et à une infrastructure conçue pour le calcul d’IA à grande échelle.
L’essor des néoclouds est étroitement lié à la demande croissante en GPU, stimulée par l’IA générative. Les entreprises, les start-up spécialisées en IA et les développeurs de modèles peuvent accéder à d’importantes capacités de calcul GPU pour entraîner et affiner leurs modèles, ainsi que pour effectuer des inférences IA, sans devoir commencer par construire un data center d’IA complet. Le GPU as a Service (GPUaaS) est ainsi devenu une offre importante pour de nombreux fournisseurs de néoclouds.
Gartner estime que d’ici 2030, les fournisseurs de néoclouds devraient détenir 20 % des parts du marché du cloud dédié à l’IA, évalué à 267 milliards de dollars.
Gartner estime que d’ici 2030, les fournisseurs de néoclouds devraient détenir 20 % des parts du marché du cloud dédié à l’IA, évalué à 267 milliards de dollars.
Cloud traditionnel ou Néocloud
Les clouds publics traditionnels fournissent des machines virtuelles, du stockage, des bases de données, des services d’analyse et un large éventail de services managés. Les principaux fournisseurs de cloud proposent désormais également de nombreux services GPU et d’IA. La distinction entre les clouds traditionnels et les Néoclouds ne tient donc pas simplement à la disponibilité de GPU, mais à la manière dont l’infrastructure sous-jacente est conçue.
Les Néoclouds sont généralement conçus dès le départ pour les charges de travail fortement dépendantes des GPU. Ils privilégient les clusters de GPU haute densité, les réseaux à large bande passante et à faible latence, ainsi qu’un accès plus direct aux ressources de calcul. Certains fournisseurs proposent également des serveurs bare metal ou des clusters de GPU dédiés aux utilisateurs qui ont besoin d’un meilleur contrôle sur la configuration matérielle ou qui réalisent des entraînements d’IA distribués à grande échelle.
Les clouds publics hyperscale offrent quant à eux des écosystèmes logiciels plus vastes, des services managés et une disponibilité mondiale. Les Néoclouds n’ont pas vocation à remplacer toutes les charges de travail exécutées sur les clouds traditionnels, mais constituent une option plus spécialisée pour les applications exigeantes d’IA et de HPC.
Quels sont les avantages du Néocloud ?
L’un des principaux avantages du Néocloud réside dans l’accès rapide à des capacités de calcul avancées sur GPU. Les organisations peuvent acquérir les ressources nécessaires à l’entraînement des modèles, à l’inférence ou à des projets spécifiques sans devoir acheter et déployer au préalable de grandes quantités de GPU.
Conçue pour les charges de travail d’IA, l’infrastructure permet d’optimiser dans un ensemble cohérent les serveurs GPU haute densité, les interconnexions haut débit et le stockage haute performance. Cela contribue à réduire les goulots d’étranglement liés aux communications dans les charges de travail d’IA distribuées. Les utilisateurs peuvent également évoluer d’instances GPU individuelles vers des clusters dédiés, en fonction de leurs besoins en calcul.
Modèles courants de services Néocloud
Les fournisseurs de Néocloud proposent différentes modalités d'accès aux ressources de calcul pour l'IA, selon la durée des charges de travail, la capacité requise et les habitudes d'utilisation.
・Instances réservées — Ressources de calcul réservées pour les charges de travail prévisibles
Conçues pour les charges de travail d'IA prévisibles et de longue durée. Les utilisateurs réservent à l'avance une capacité GPU ou des ressources de calcul afin de bénéficier d'une disponibilité et de performances plus constantes. Ce modèle convient notamment à l'entraînement de modèles à grande échelle ou à l'inférence d'IA continue.
・Instances à la demande — Accès à la demande à des ressources de calcul d'IA partagées
Les utilisateurs obtiennent des GPU et d'autres ressources de calcul à partir de pools partagés, selon leurs besoins, et paient en fonction de leur utilisation réelle, sans engagement à long terme. Ce modèle convient particulièrement au développement et aux tests d'IA, à l'affinage des modèles et aux charges de travail dont la demande varie.
・Plateformes serverless — Services d'IA sans gestion directe de l'infrastructure
Le fournisseur gère le matériel sous-jacent, le provisionnement, la mise à l'échelle et la gestion du cycle de vie. Les développeurs peuvent ainsi accéder aux modèles d'IA et aux ressources de calcul via une plateforme gérée ou une API, sans gérer directement les serveurs. Ce modèle convient particulièrement à l'intégration rapide de modèles d'IA dans des applications en production.
En quoi GIGABYTE est-il utile ?
La mise à l’échelle d’un néocloud ne se résume pas à ajouter des GPU. Le réseau, le stockage, l’alimentation électrique, le refroidissement et la gestion des systèmes doivent évoluer au même rythme que la capacité de calcul.
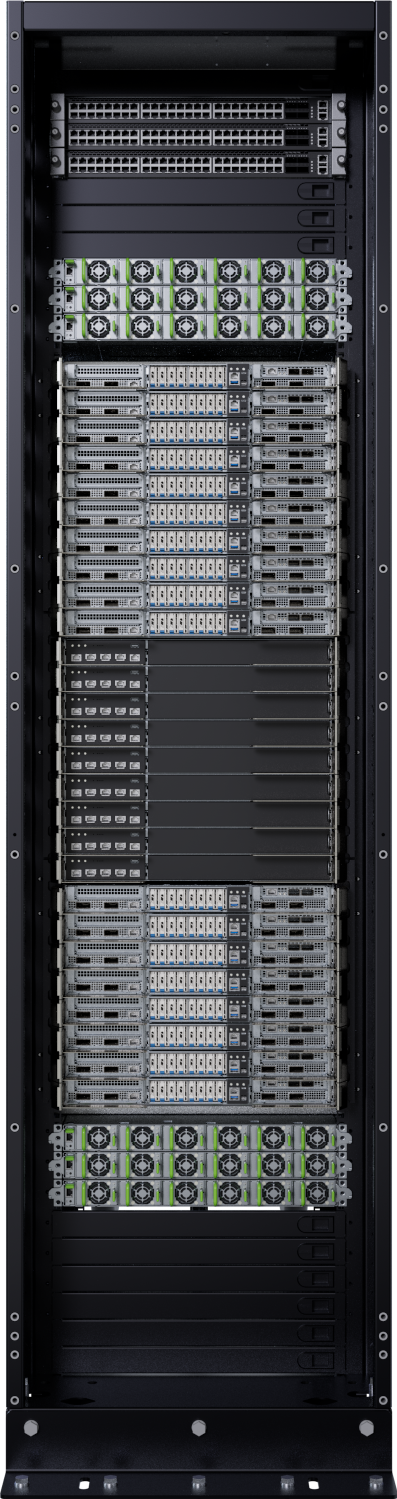
GIGABYTE propose un vaste portefeuille allant des serveurs GPU haute densité aux plateformes de calcul IA à l’échelle du rack pour l’entraînement des modèles d’IA et l’inférence à grande échelle. GIGAPOD intègre le calcul GPU, le réseau haut débit et l’infrastructure au sein d’une plateforme évolutive, tandis que GIGABYTE POD Manager (GPM) assure la supervision centralisée des systèmes et la gestion des ressources.
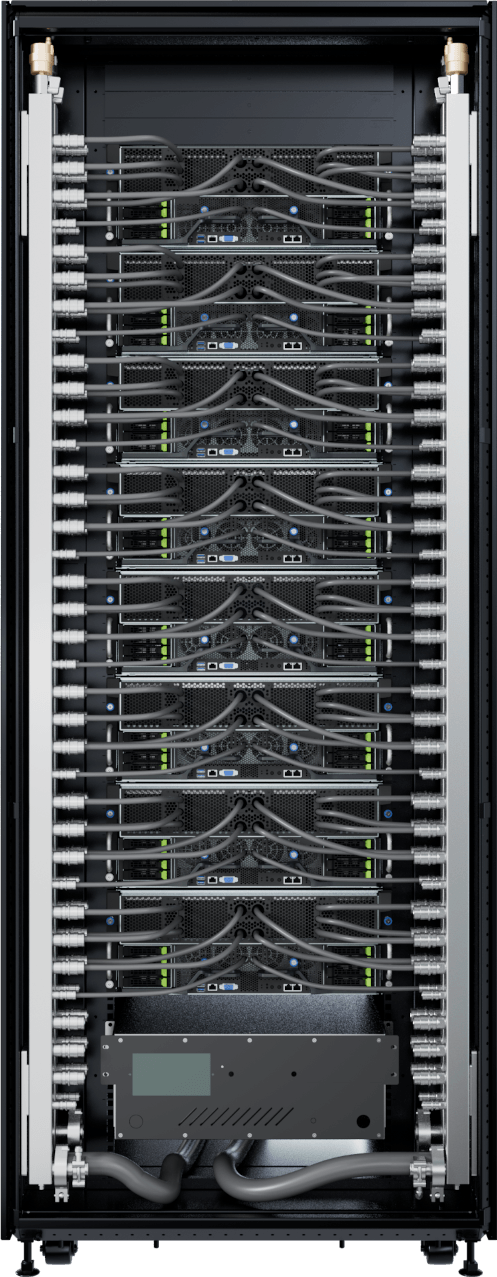
À mesure que la puissance des GPU et la densité thermique augmentent, des technologies de refroidissement avancées telles que le refroidissement liquide direct (DLC) peuvent renforcer les déploiements haute densité et aider les fournisseurs de services néocloud et cloud à mettre en place une infrastructure IA évolutive.