GPU (Graphics Processing Unit)
Unité de traitement graphique
Qu’est-ce qu’une unité de traitement graphique (GPU) ?
Le GPU, ou unité de traitement graphique, est un processeur conçu pour le calcul parallèle, capable d’exécuter simultanément un grand nombre d’opérations similaires. Les GPU ont été développés à l’origine principalement pour le rendu graphique. Ils utilisent le traitement parallèle pour accélérer les calculs mathématiques nécessaires à la génération des graphismes de jeux vidéo, des modèles 3D et des images numériques.
À mesure que les GPU sont devenus de plus en plus programmables, leurs applications se sont étendues au-delà du traitement graphique pour inclure le calcul généraliste. Cette approche, appelée GPGPU (General-Purpose Computing on Graphics Processing Units), permet aux GPU de traiter des charges de travail non graphiques nécessitant une puissance de calcul importante.
Des composants graphiques intégrés aux ordinateurs personnels aux processeurs puissants prenant en charge des charges de travail informatiques à grande échelle, les GPU ont largement dépassé leur rôle initial dans le rendu graphique. Aujourd’hui, ils constituent des ressources de calcul essentielles pour l’intelligence artificielle (IA) et le calcul haute performance (HPC).
Pourquoi les unités de traitement graphique sont-elles importantes et à quoi servent-elles ?
Dans les applications grand public, les unités de traitement graphique sont principalement chargées du rendu des graphismes des jeux, du ray tracing et du traitement des effets visuels. Les unités de traitement graphique plus puissantes offrent généralement une expérience de jeu plus fluide avec des résolutions et des paramètres graphiques plus élevés, permettant aux joueurs de profiter d'environnements virtuels plus réalistes et immersifs.
Pour les créateurs de contenu professionnels, les unités de traitement graphique accélèrent la modélisation 3D, le rendu des animations, le montage vidéo et la production d'effets visuels, réduisant considérablement le temps nécessaire à la réalisation des projets créatifs. Les grandes équipes de production peuvent utiliser des stations de travail ou des serveurs de rendu dédiés pour traiter des charges de travail complexes, tandis que les studios plus petits peuvent faire appel à des fermes de rendu dans le cloud afin d'accéder aux ressources de calcul à la demande et d'améliorer leur efficacité de production.
Dans les environnements d'entreprise et de recherche, les unités de traitement graphique sont largement utilisées pour le calcul haute performance (HPC), les simulations scientifiques, les analyses d'ingénierie et le traitement de données à grande échelle. Ces charges de travail impliquant souvent un très grand nombre d'opérations mathématiques pouvant être exécutées simultanément, les unités de traitement graphique peuvent exploiter leurs capacités de traitement parallèle pour accélérer les calculs et les analyses complexes.
Avec les progrès rapides de l'IA, les unités de traitement graphique sont également devenues essentielles à l'entraînement et à l'inférence des modèles. Lors de l'entraînement, les grands modèles de langage (LLM), les modèles multimodaux et les modèles d'IA générative nécessitent souvent plusieurs unités de traitement graphique fonctionnant conjointement pour traiter d'immenses jeux de données et charges de calcul. Une fois déployés, ces modèles bénéficient également de l'accélération de l'inférence par les unités de traitement graphique, ce qui permet de proposer un large éventail de services d'IA en temps réel.
En outre, l'émergence de l'IA de raisonnement et de l'IA agentique stimule davantage la demande en capacités de calcul dédiées à l'inférence. Ces systèmes d'IA mettent souvent en œuvre des processus de raisonnement plus complexes, des tâches en plusieurs étapes et des appels répétés aux modèles, ce qui accroît les ressources de calcul nécessaires à l'inférence. Des unités de traitement graphique individuelles et des serveurs GPU de niveau entreprise aux clusters d'accélérateurs GPU à grande échelle, les unités de traitement graphique sont devenues des ressources de calcul indispensables au cœur des usines d'IA modernes.
GPU ou CPU : quelle différence ?
Les CPU et les GPU sont tous deux des processeurs, mais ils sont conçus pour des types de tâches différents.
Les CPU disposent d’un nombre réduit de cœurs plus polyvalents, capables de gérer des instructions complexes, le contrôle du système et des tâches qui évoluent rapidement. Les GPU utilisent un grand nombre de cœurs spécialisés pour exécuter en parallèle des opérations similaires.
Dans les systèmes d’IA, les GPU prennent généralement en charge l’entraînement et l’inférence des modèles, tandis que les CPU gèrent le traitement des données, les services applicatifs, le stockage et les E/S réseau, l’orchestration des modèles ainsi que les workflows d’IA agentique.
La question n’est donc pas simplement de choisir entre CPU et GPU, mais de déterminer comment répartir efficacement les charges de travail entre les deux et assurer les échanges de données.
En savoir plus :CPU ou GPU : quel processeur choisir ?
En savoir plus :CPU ou GPU : quel processeur choisir ?
GPU ou carte graphique : quelle différence ?
Un GPU est le processeur qui effectue les calculs, tandis qu’une carte graphique est un produit matériel complet conçu autour de ce GPU.
Dans les centres de données, les GPU peuvent prendre la forme d’accélérateurs PCIe, de modules GPU haute densité ou de plateformes intégrées de calcul accéléré. Dans les domaines de l’IA et du HPC, le terme GPU désigne donc un accélérateur de calcul, et non pas simplement un composant destiné à l’affichage graphique.
En plus du GPU, une carte graphique intègre généralement de la VRAM, un circuit imprimé, un système d’alimentation, un dispositif de refroidissement et des interfaces d’affichage. Dans les ordinateurs personnels, les GPU sont généralement proposés sous la forme de cartes graphiques discrètes.
Dans les centres de données, les GPU peuvent prendre la forme d’accélérateurs PCIe, de modules GPU haute densité ou de plateformes intégrées de calcul accéléré. Dans les domaines de l’IA et du HPC, le terme GPU désigne donc un accélérateur de calcul, et non pas simplement un composant destiné à l’affichage graphique.
Comment GIGABYTE peut-il vous aider ?
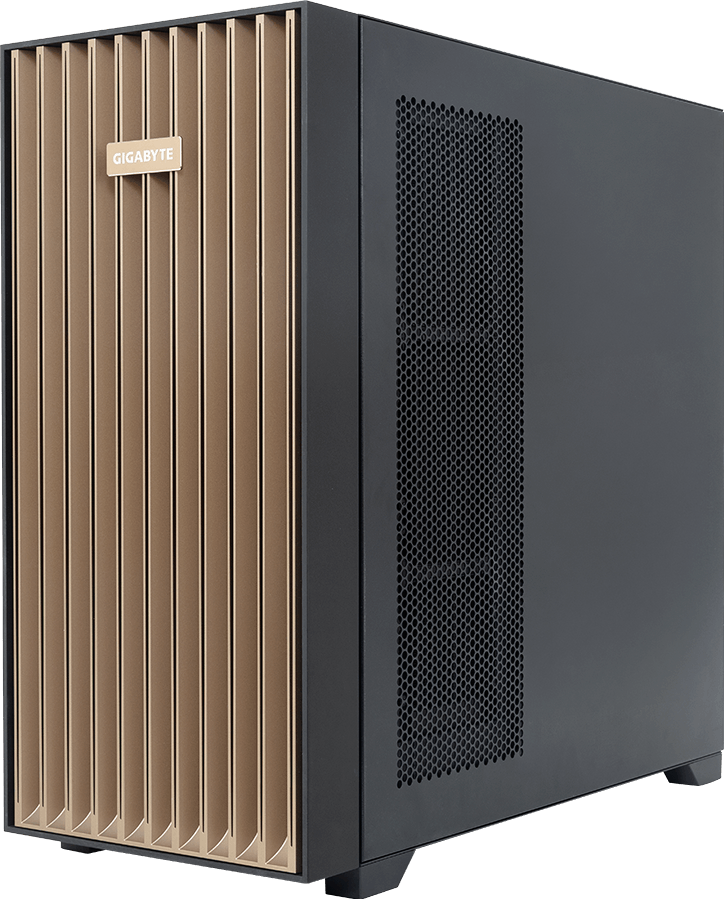
Pour les particuliers, GIGABYTE propose des cartes graphiques basées sur les technologies NVIDIA et AMD dans les gammes AORUS, GAMING, AERO et EAGLE, destinées au gaming, à la création assistée par l'IA et à la production de contenu, avec des options de refroidissement par air ou liquide.
L'accélération par GPU s'étend également aux ordinateurs portables GIGABYTE et AORUS. Des systèmes gaming hautes performances aux ordinateurs portables pour créateurs et aux PC dotés de capacités d'IA, les GPU dédiés prennent en charge non seulement le gaming, mais aussi la modélisation 3D, la production vidéo, l'IA générative et d'autres charges de travail d'IA locales.
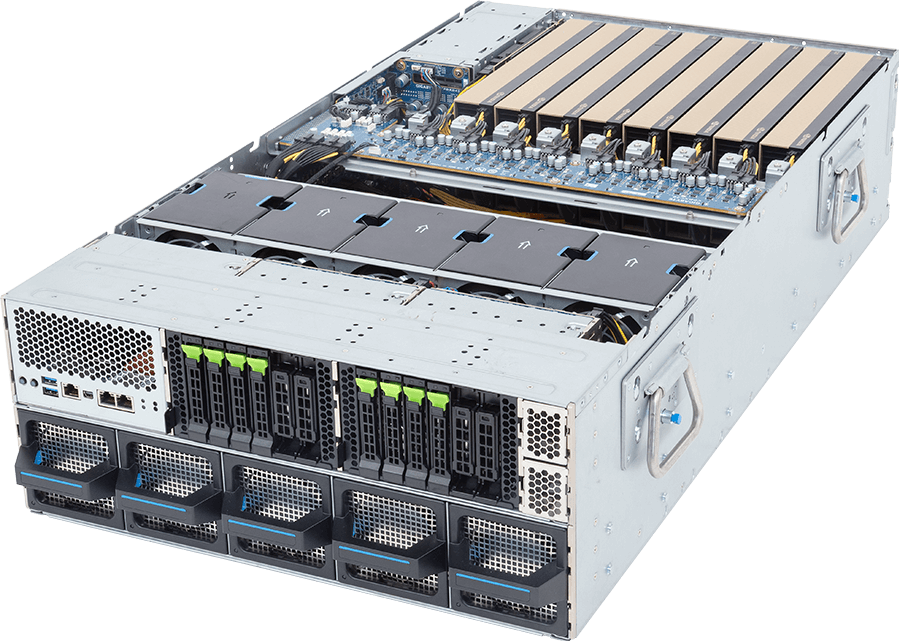
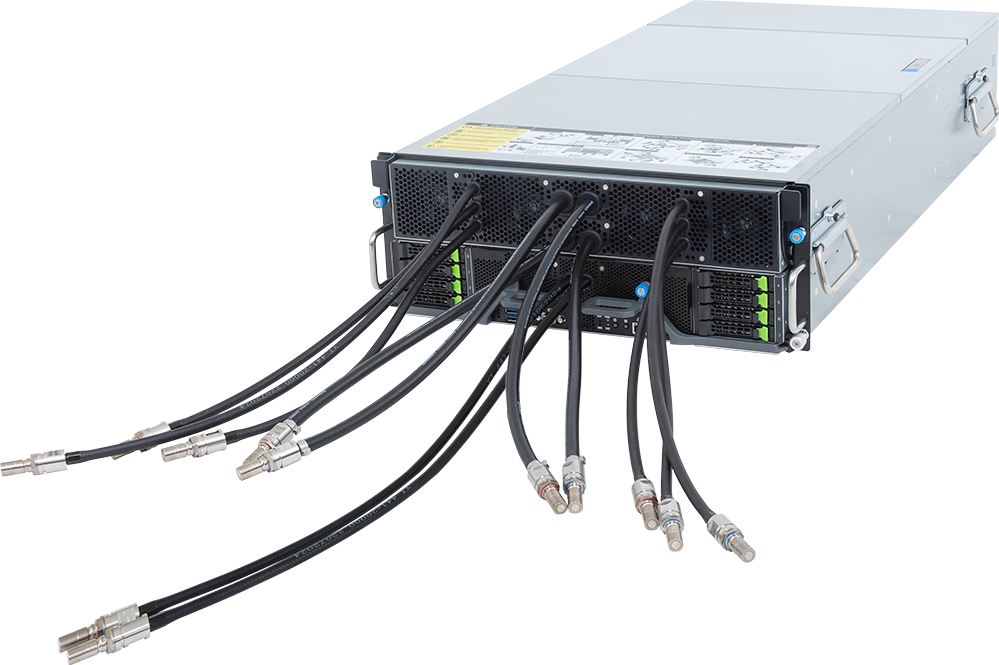
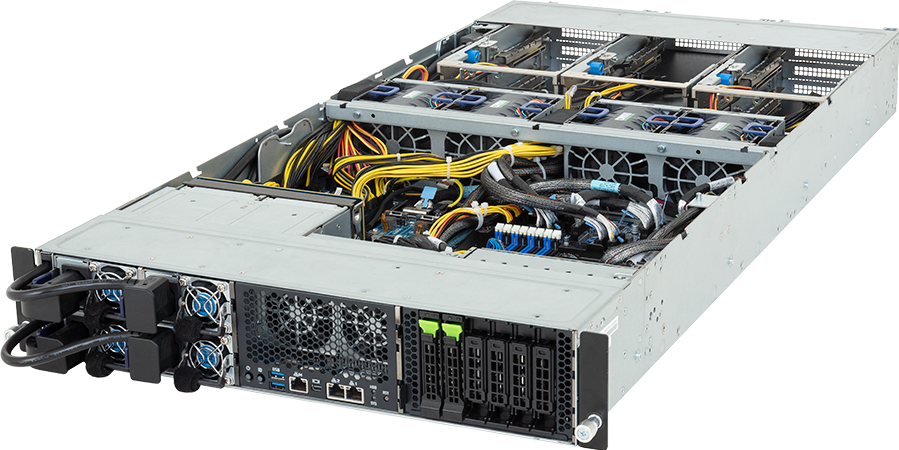
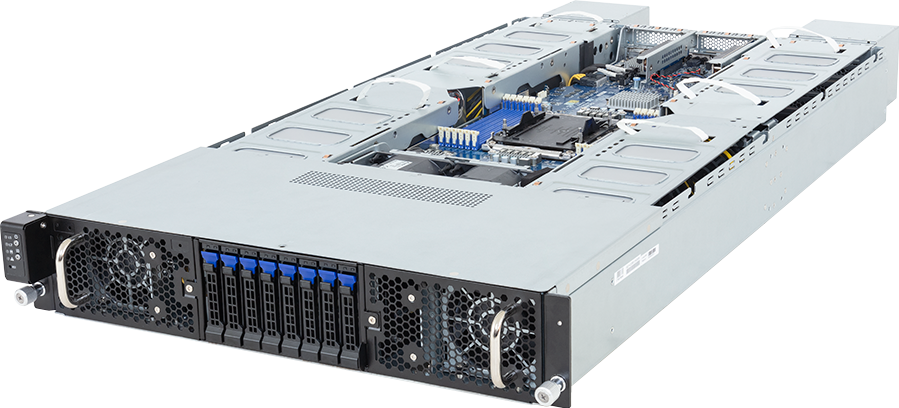
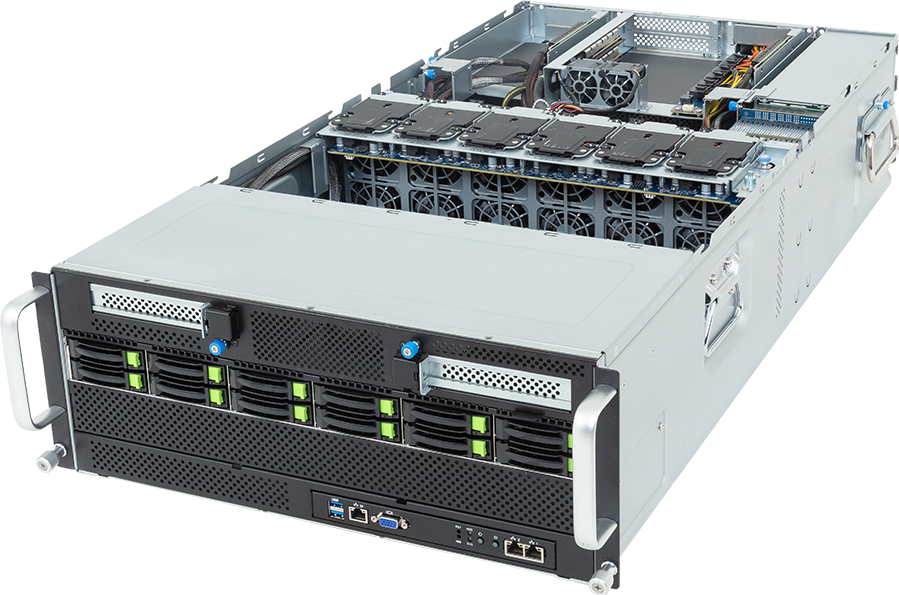
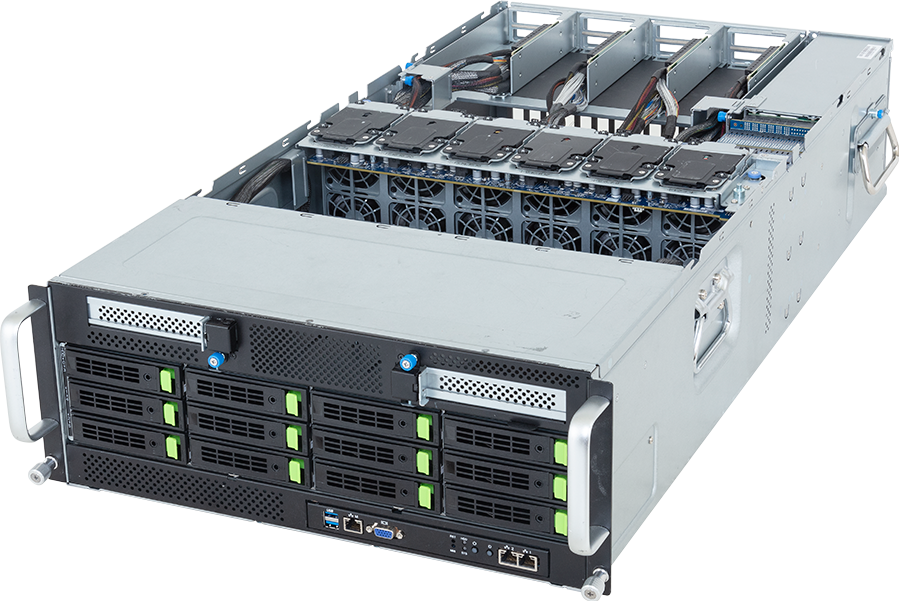
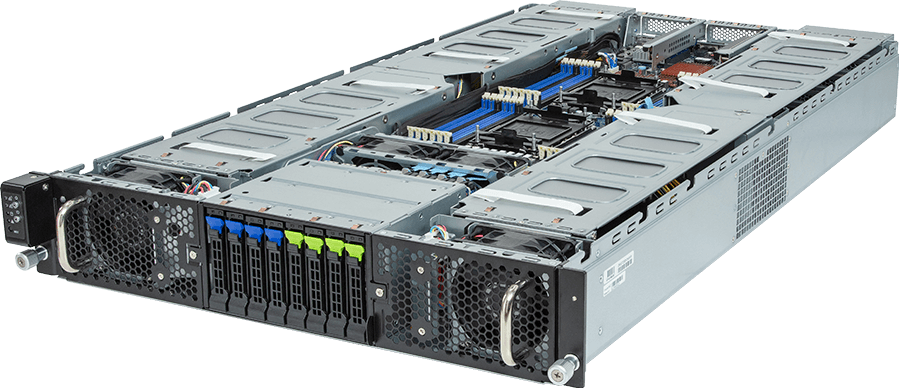
Pour l'informatique d'entreprise, GIGABYTE propose une vaste gamme de plateformes serveurs équipées de GPU et d'accélérateurs d'IA, compatibles avec différents fournisseurs, spécifications et formats, allant des accélérateurs PCIe et des modules haute densité aux plateformes de calcul d'IA à grande échelle pour l'entraînement, l'inférence, le calcul haute performance (HPC), les jumeaux numériques et la recherche scientifique.
Ces plateformes sont également utilisées dans le cadre de projets de recherche scientifique concrets. Le CERN a déployé des serveurs GPU GIGABYTE pour prendre en charge l'analyse des données du Grand collisionneur de hadrons, tandis que l'observatoire Lowell a utilisé des systèmes GIGABYTE pour ses recherches sur les exoplanètes. Le calcul sur GPU a considérablement évolué : des premières charges de travail GPGPU exécutées sur un seul serveur aux grands clusters actuels reliés par des interconnexions haut débit.
Pour les déploiements d'usines d'IA, GIGAPOD intègre des serveurs GPU, des réseaux haut débit, du stockage, des systèmes de refroidissement et GIGABYTE POD Manager (GPM). Cette solution permet de faire évoluer le calcul sur GPU, des systèmes personnels et des serveurs individuels jusqu'aux infrastructures d'IA à l'échelle d'un rack ou d'un cluster.