Distributed Computing
Computación distribuida
¿Qué es?
La computación distribuida es un modelo en el que distintos componentes de un software se ejecutan en varias computadoras, pero funcionan como un solo sistema. Por ejemplo, cada vez que buscas algo en un navegador web, tu solicitud en realidad es procesada por distintos servidores ubicados en diferentes lugares. Cada uno prepara su respuesta de manera independiente. Después, los resultados se agregan y se muestran en el dispositivo desde el que realizaste la búsqueda, sin que te enteres de cuántos servidores lograron —o no lograron— ayudarte a encontrar la información. Este es el poder de la computación distribuida: permite que una computadora aproveche los recursos de otras, al mismo tiempo que evita que la falla de una sola computadora ponga en riesgo toda la tarea.
Cabe señalar que, aunque la computación distribuida es el término general que engloba otros conceptos similares, como la computación paralela y la computación en grid, los métodos son diferentes. La computación paralela implica un nivel mucho mayor de coordinación y uso compartido de recursos entre cada nodo, mientras que la computación en grid tiende a ser más heterogénea e involucra computadoras con conexiones más flexibles. La forma de computación distribuida más adecuada depende, en gran medida, de la tarea que necesitas realizar.
Cabe señalar que, aunque la computación distribuida es el término general que engloba otros conceptos similares, como la computación paralela y la computación en grid, los métodos son diferentes. La computación paralela implica un nivel mucho mayor de coordinación y uso compartido de recursos entre cada nodo, mientras que la computación en grid tiende a ser más heterogénea e involucra computadoras con conexiones más flexibles. La forma de computación distribuida más adecuada depende, en gran medida, de la tarea que necesitas realizar.
¿Por qué lo necesita?
Los beneficios de la computación distribuida se resumen perfectamente en el viejo refrán: «no ponga todos los huevos en la misma canasta». La computación distribuida ofrece redundancia rentable, ya que un gran número de computadoras pequeñas puede trabajar en conjunto para alcanzar un objetivo común, y la falla de una de ellas no afecta a todo el sistema. La escalabilidad también es mucho mejor con la computación distribuida, porque es posible agregar o retirar nodos según sea necesario. Si se utiliza la computación paralela para asignar una gran cantidad de recursos informáticos a un único objetivo, es posible alcanzar el nivel de HPC (computación de alto rendimiento).
¿Cómo ayuda GIGABYTE?
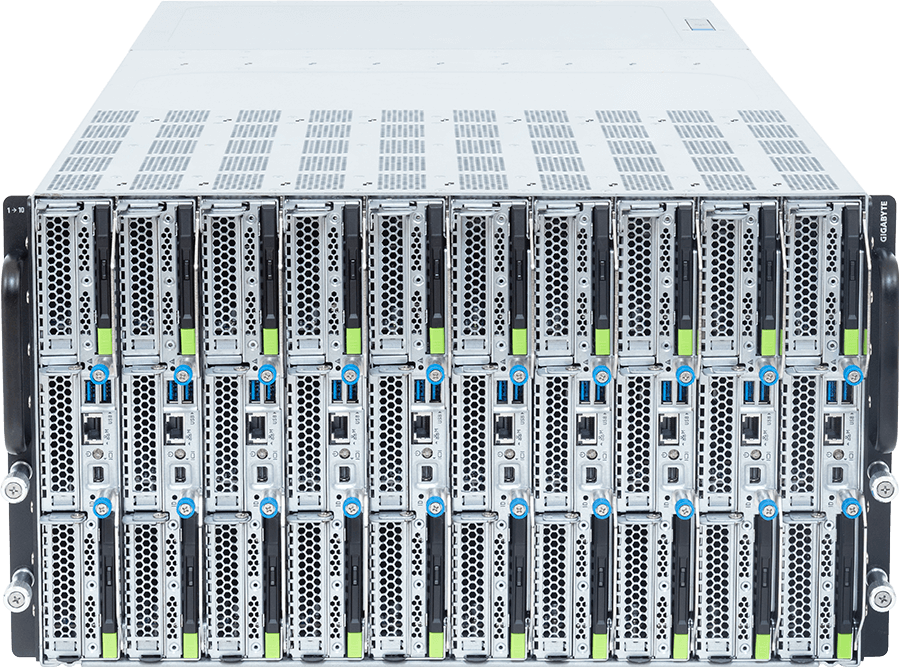
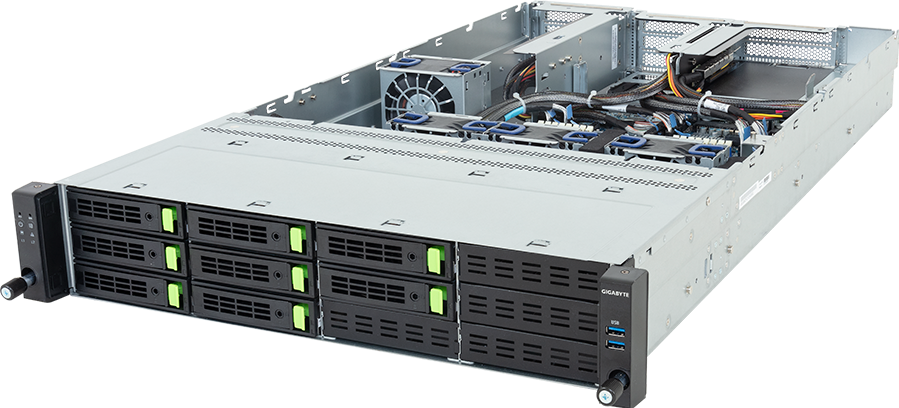
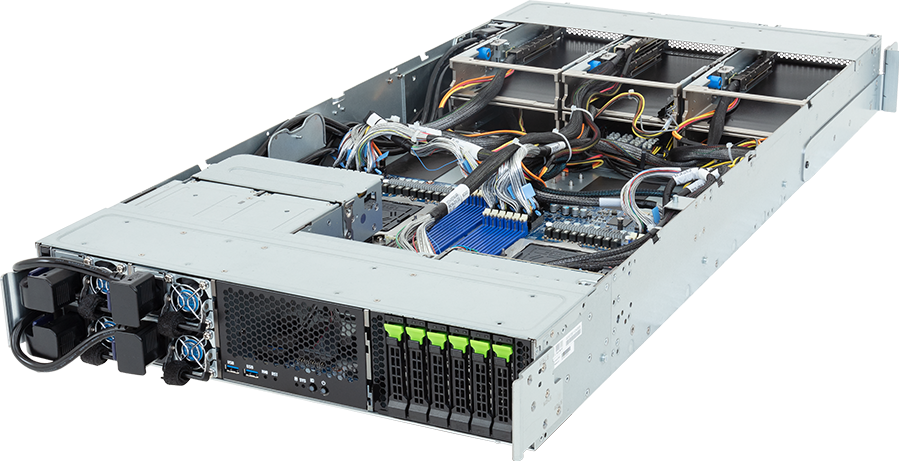
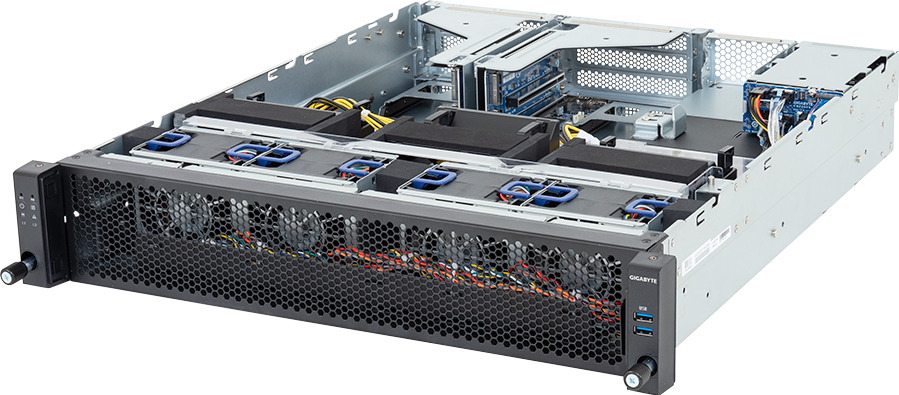
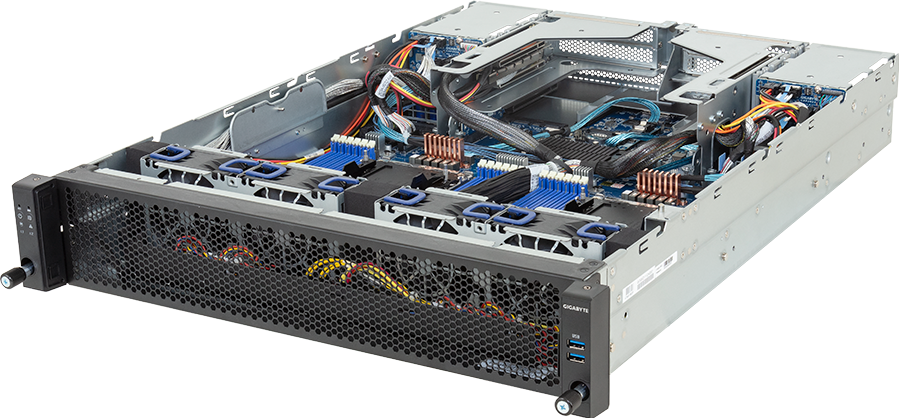
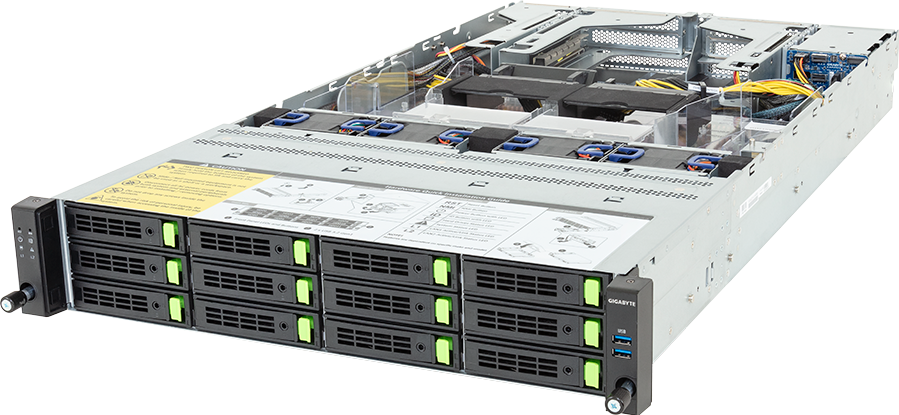
Por definición, la computación distribuida depende de un gran número de servidores que desempeñan distintas funciones. Esta es precisamente la especialidad de GIGABYTE. Si busca servidores adecuados para la computación paralela, los servidores GPU serie G pueden ser ideales, ya que combinan las ventajas de las CPU y las GPGPU mediante la computación heterogénea para ofrecer resultados sobresalientes. Otras líneas de productos destacadas incluyen los servidores de alta densidad serie H, que pueden alojar un gran número de nodos en formatos compactos; los servidores en rack serie R, versátiles y capaces de cubrir las necesidades de su sistema de computación distribuida; y los servidores de almacenamiento serie S, que suelen implementarse en grandes cantidades en el nodo de almacenamiento de un clúster de cómputo o una granja de servidores. En la computación en la nube, la distribución de las tareas de cómputo entre los centros de datos en la nube y los dispositivos de computación en el borde también puede considerarse una forma de computación distribuida. La solución de GIGABYTE para este escenario son los servidores perimetrales serie E, diseñados para ayudar a ampliar la cobertura en la periferia de la red.