AI Training
Entrenamiento de IA
¿Qué es?
La inteligencia artificial (IA) moderna es capaz de realizar diversas tareas, desde generar textos e imágenes hasta pilotar un vehículo autónomo, porque se desarrolla mediante un proceso conocido como aprendizaje automático o aprendizaje profundo. Los dos componentes principales del aprendizaje son el «entrenamiento» y la «inferencia».
Durante el entrenamiento, se introduce una cantidad ingente de datos en el modelo de IA. Por lo general, los datos están etiquetados y hay programadores humanos disponibles para supervisar el proceso, aunque las formas más avanzadas de IA pueden realizar un entrenamiento autosupervisado o semisupervisado con datos sin etiquetar. La IA analiza los datos de entrada e intenta generar el resultado esperado; por ejemplo, tratará de identificar fotografías de perros entre una gran cantidad de imágenes de animales. En función de la validez del resultado, es decir, de si la predicción es correcta o no, la IA ajusta su proceso de toma de decisiones asignando puntuaciones ponderadas, también denominadas «sesgos», a los parámetros de los datos.
Mediante iteraciones repetidas de predicciones (propagaciones hacia delante) y retroalimentación (propagaciones hacia atrás), las ponderaciones alcanzan tal nivel de precisión que siempre se seleccionan las conexiones adecuadas. Así es como se entrena la IA para reconocer los datos con los que está diseñada para trabajar.
¿Por qué lo necesita?
Junto con la inferencia, el entrenamiento de IA es una parte intrínseca e inseparable de la forma en que la IA moderna «aprende». En lugar de depender de que los programadores escriban código para cada posible situación, la IA se entrena analizando una enorme cantidad de big data hasta estar preparada para trabajar con datos nuevos y sin etiquetar en situaciones reales.
Tomemos como ejemplo la visión artificial aplicada al reconocimiento de matrículas. Las estaciones de peaje electrónico de las autopistas deben poder leer las letras y los números de las matrículas de los vehículos que pasan. Las distintas matrículas pueden utilizar tipografías diferentes; la propia matrícula puede estar torcida, inclinada o borrosa, y los vehículos pueden circular a velocidades distintas. La única razón por la que la IA sigue siendo capaz de leer la información correctamente es que se ha entrenado con una cantidad de datos tan grande que puede interpretar la entrada con precisión en cada ocasión.
¿Cómo ayuda GIGABYTE?
La cantidad de datos digitales y recursos informáticos necesarios para el entrenamiento de IA no solo es impresionante, sino que además aumenta de forma exponencial. Utilizar una infraestructura de IA con aceleración mediante GPU y computación paralela es imprescindible, especialmente porque los desarrolladores de la competencia también se apresuran por lanzar sus productos de IA al mercado.
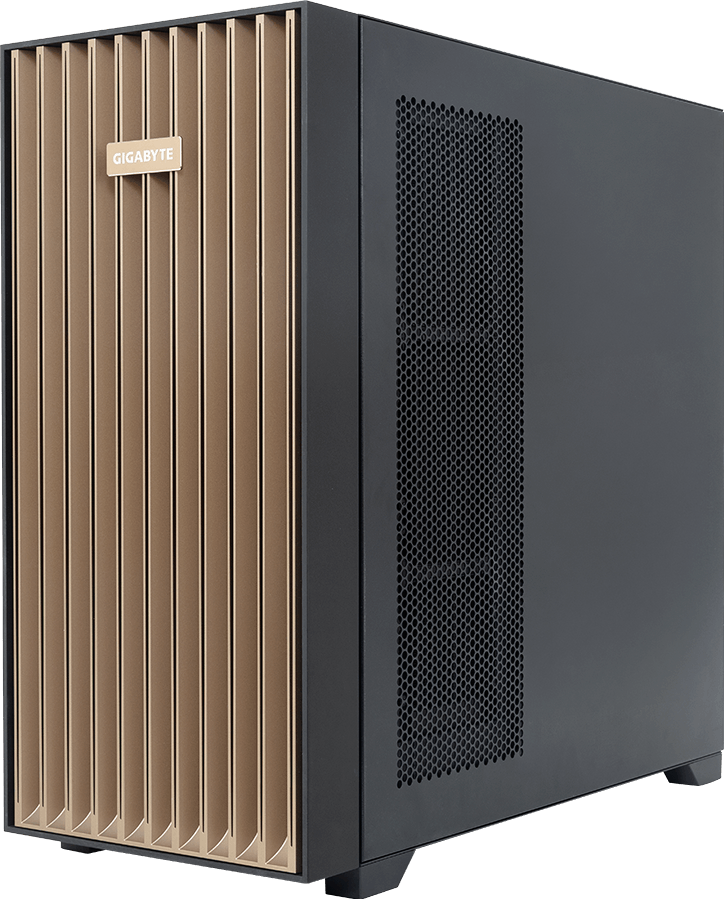
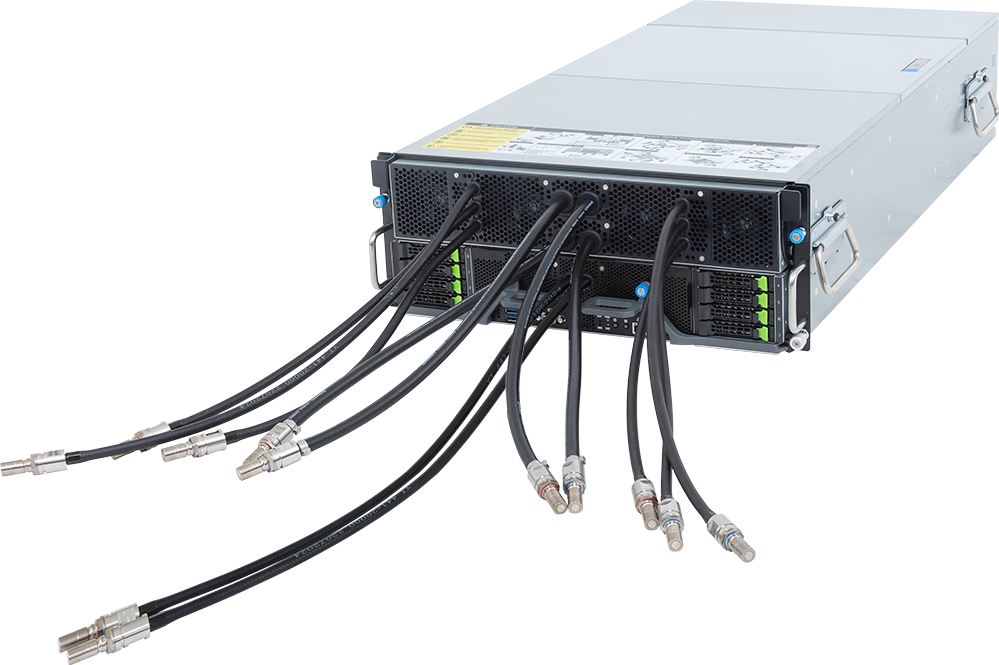
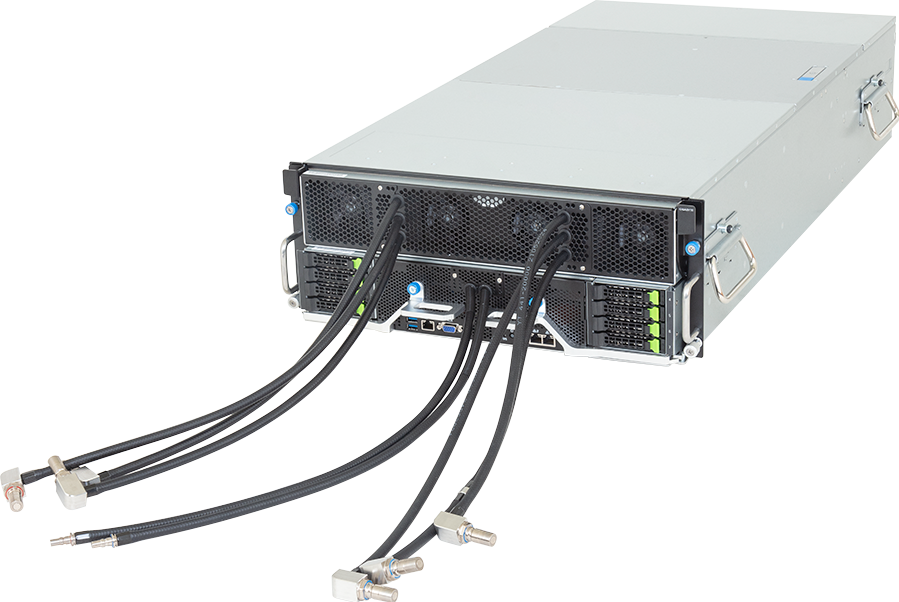
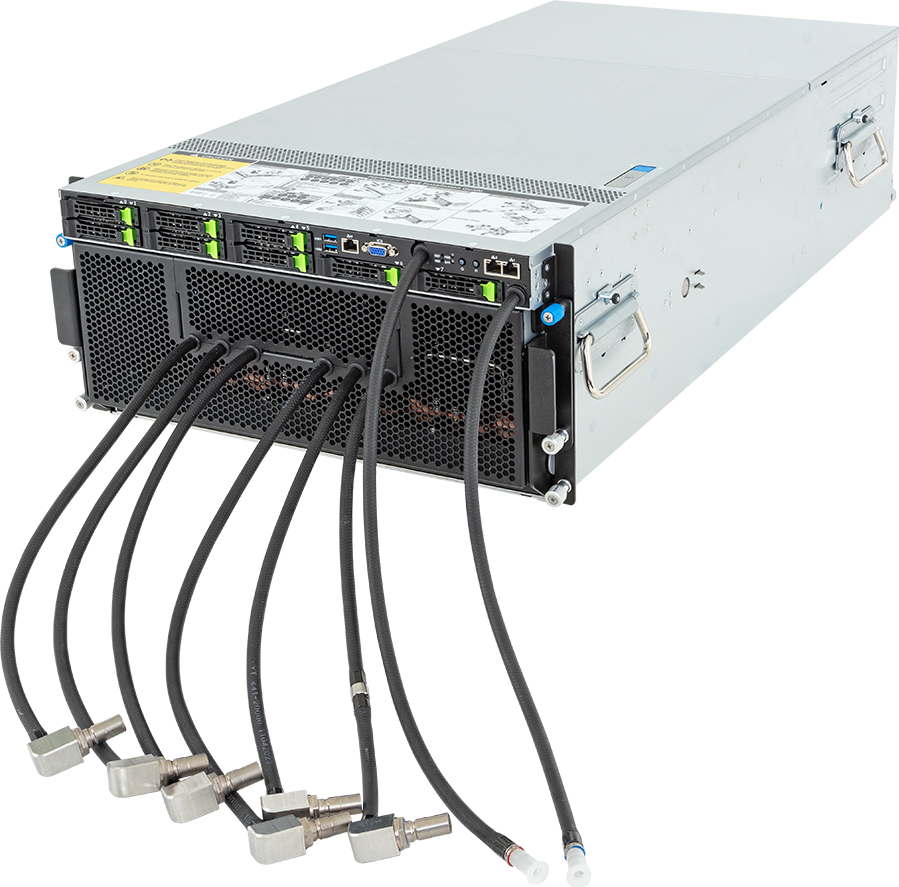
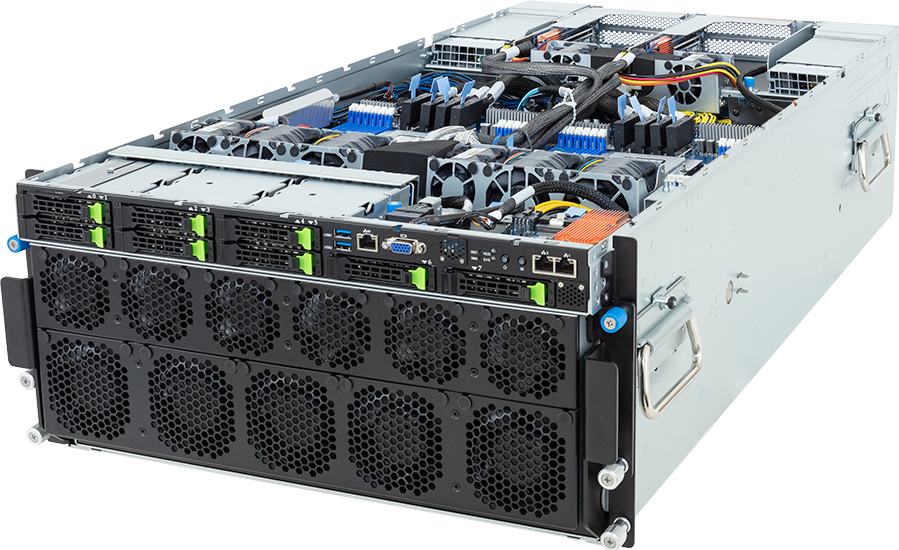
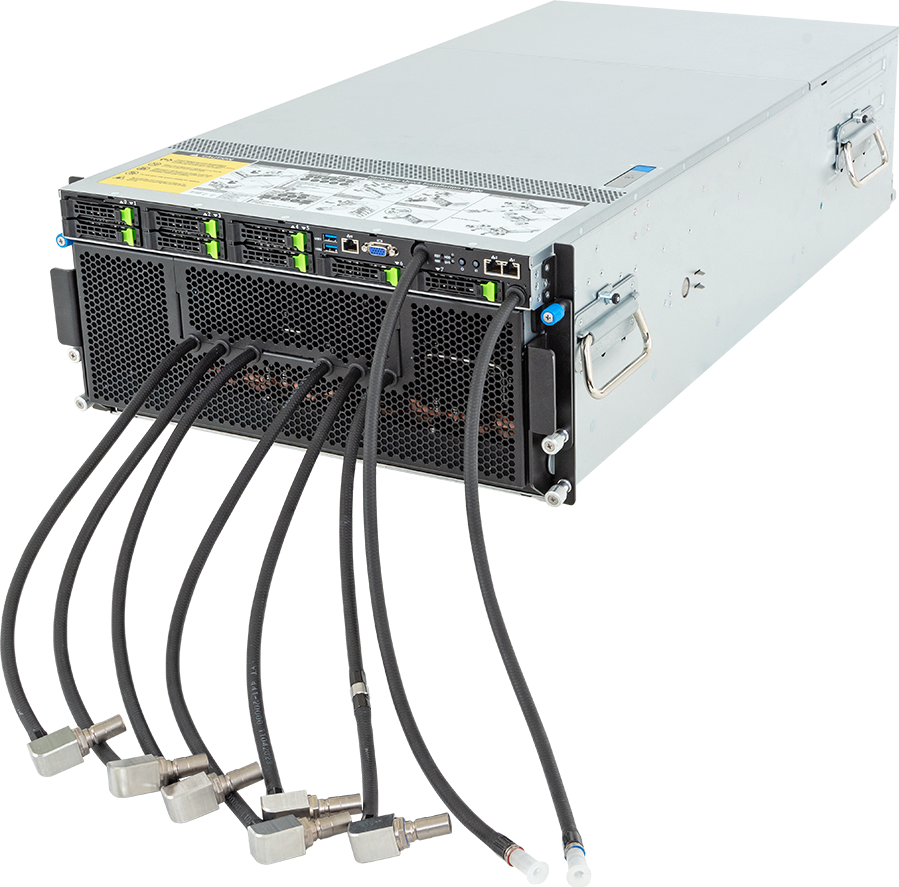
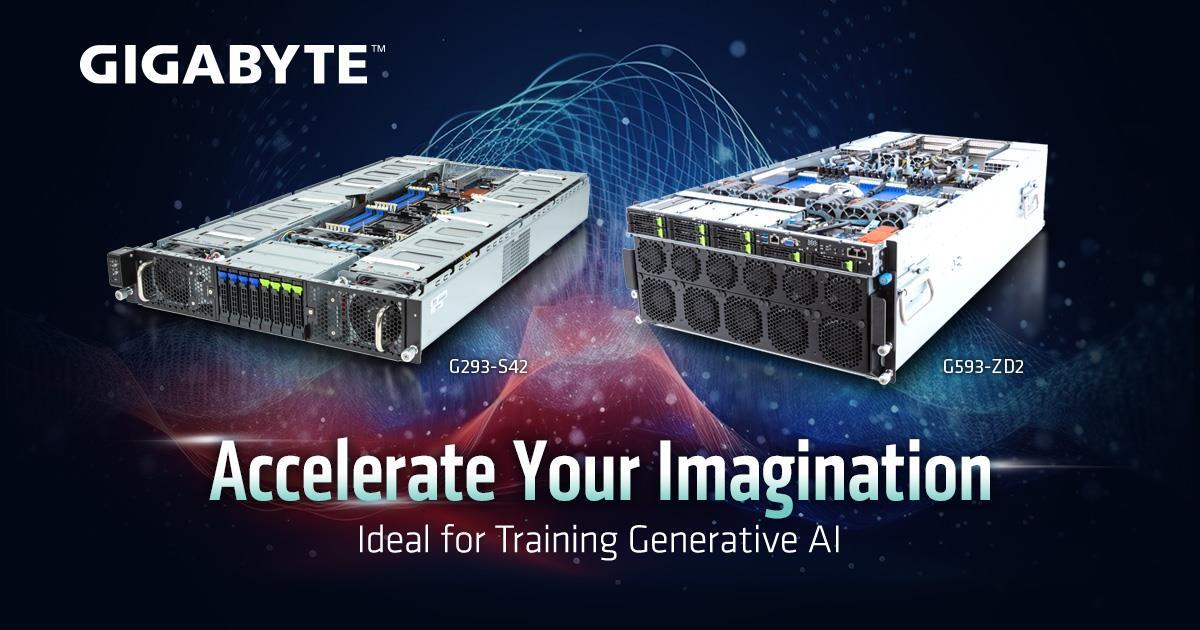
Los servidores GPU de la serie G de GIGABYTE Technology se encuentran entre los servidores de IA más potentes del sector. En particular, los modelos G593-SD0 y G593-ZD2 combinan el módulo de computación HGX™ H100 con 8 GPU de NVIDIA con procesadores Intel® Xeon® Scalable de 4.ª generación o AMD EPYC™ 9004, respectivamente. Son capaces de ofrecer más de 32 petaflops de rendimiento de computación para IA, lo que convierte a estos productos en una opción natural para aplicaciones de procesamiento del lenguaje natural (NLP) y modelos de lenguaje de gran escala (LLM). Toda esta capacidad de supercomputación cabe en un servidor 5U gracias a la tecnología de refrigeración y al diseño del chasis propios de GIGABYTE, que contribuyen a mejorar la densidad de computación.
Además de hardware de servidor de última generación, GIGABYTE también recomienda el sistema de entrenamiento DNN Myelintek MLSteam, que forma parte de la solución de entrenamiento DNN de GIGABYTE. Se trata de una plataforma de entrenamiento DNN lista para usar, con un entorno preinstalado, verificado y optimizado que incluye algunos de los frameworks y bibliotecas de aprendizaje profundo más populares. El backend de esta solución también es un servidor GPU de la serie G.
Más información: 《Impulsa la IA con las soluciones de servidores de IA de alto rendimiento de GIGABYTE》
Los servidores GPU de la serie G de GIGABYTE Technology se encuentran entre los servidores de IA más potentes del sector. En particular, los modelos G593-SD0 y G593-ZD2 combinan el módulo de computación HGX™ H100 con 8 GPU de NVIDIA con procesadores Intel® Xeon® Scalable de 4.ª generación o AMD EPYC™ 9004, respectivamente. Son capaces de ofrecer más de 32 petaflops de rendimiento de computación para IA, lo que convierte a estos productos en una opción natural para aplicaciones de procesamiento del lenguaje natural (NLP) y modelos de lenguaje de gran escala (LLM). Toda esta capacidad de supercomputación cabe en un servidor 5U gracias a la tecnología de refrigeración y al diseño del chasis propios de GIGABYTE, que contribuyen a mejorar la densidad de computación.
Además de hardware de servidor de última generación, GIGABYTE también recomienda el sistema de entrenamiento DNN Myelintek MLSteam, que forma parte de la solución de entrenamiento DNN de GIGABYTE. Se trata de una plataforma de entrenamiento DNN lista para usar, con un entorno preinstalado, verificado y optimizado que incluye algunos de los frameworks y bibliotecas de aprendizaje profundo más populares. El backend de esta solución también es un servidor GPU de la serie G.
Más información: 《Impulsa la IA con las soluciones de servidores de IA de alto rendimiento de GIGABYTE》