Server Manufacturing Levels
Niveles de fabricación de servidores
¿Qué son los niveles de fabricación de servidores? Comprenda la integración L6, L10, L11 y L12
En la fabricación de servidores y la integración de sistemas para centros de datos, algunos ODM, OEM e integradores de sistemas utilizan los niveles del 1 al 12 para describir distintos grados de fabricación e integración. El alcance exacto de cada nivel puede variar según el fabricante, el diseño del producto y los requisitos del proyecto. En términos generales, L6 se refiere a un sistema de servidor barebone, L10 a un servidor completo, L11 a la integración a escala de rack y L12 a la integración de varios racks y a nivel de clúster.
Construir un servidor de IA implica mucho más que instalar CPU, GPU, memoria y dispositivos de almacenamiento en un chasis. También requiere una planificación minuciosa para gestionar el alto consumo de energía, la refrigeración de alta densidad, las interconexiones entre GPU del clúster, la distribución de energía en el rack, las redes de alta velocidad, la refrigeración líquida y la validación de la estabilidad y el rendimiento antes de realizar una implementación a gran escala. La mayoría de estos requisitos se atienden durante las últimas etapas de integración, por lo que L10, L11 y L12 son componentes importantes de la implementación de infraestructura de IA.
En las siguientes secciones se explican el alcance habitual y las principales diferencias entre L6, L10, L11 y L12.
¿Qué es L6? Sistema barebones de servidor
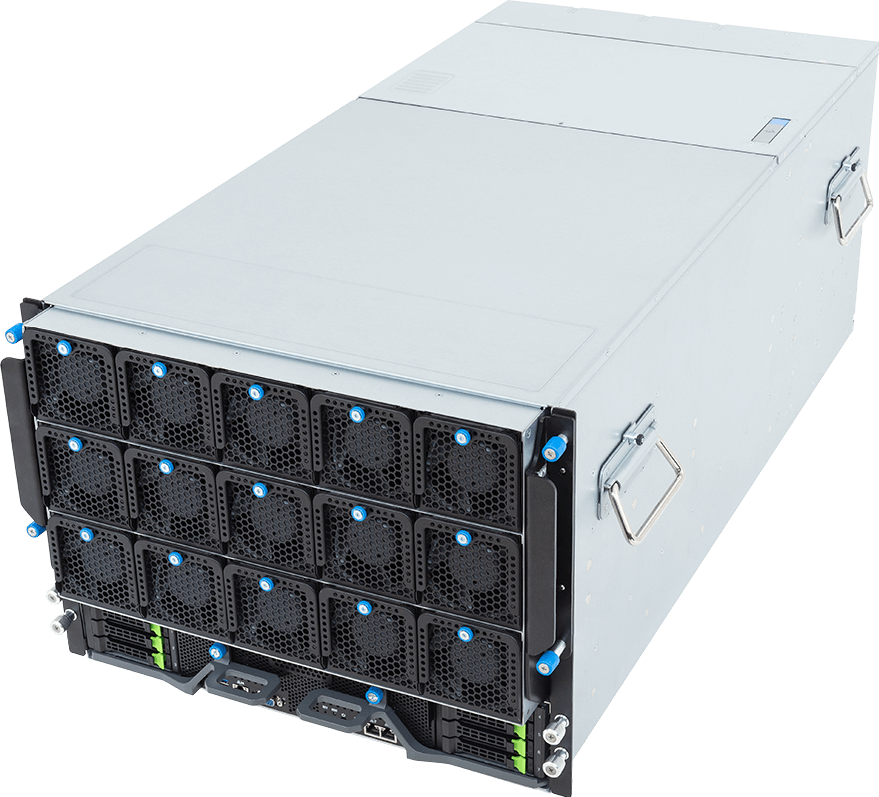
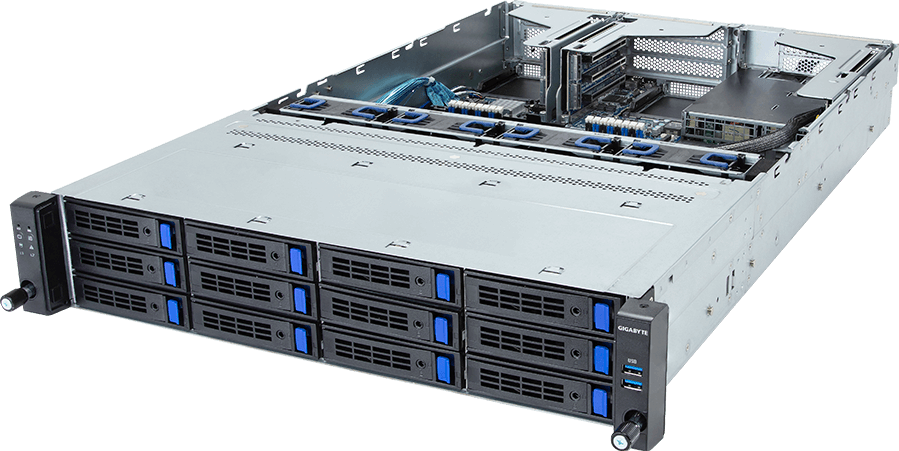
L6 generalmente se refiere a la etapa barebones del servidor, en la que la tarjeta madre, el chasis, la fuente de alimentación, los componentes de enfriamiento, el backplane y la E/S básica se integran en una plataforma de hardware.
En esta etapa, es posible que el sistema aún no incluya el conjunto completo de CPU, GPU, memoria, dispositivos de almacenamiento ni tarjetas de expansión. Por lo tanto, puede considerarse una estructura básica de servidor que todavía debe configurarse según los requisitos del cliente.
Durante las siguientes etapas de fabricación, se agregan procesadores, memoria, dispositivos de almacenamiento, aceleradores, tarjetas de red y otros componentes de expansión de acuerdo con el diseño del producto y las especificaciones del pedido. A continuación, el sistema pasa a L10 para completar la integración del servidor. Debido a que los fabricantes pueden definir las etapas intermedias de manera diferente, la secuencia exacta de instalación y el alcance de las pruebas deben determinarse conforme a las especificaciones del proveedor o del proyecto.
¿Qué es L10? Ensamblaje y validación completos del servidor
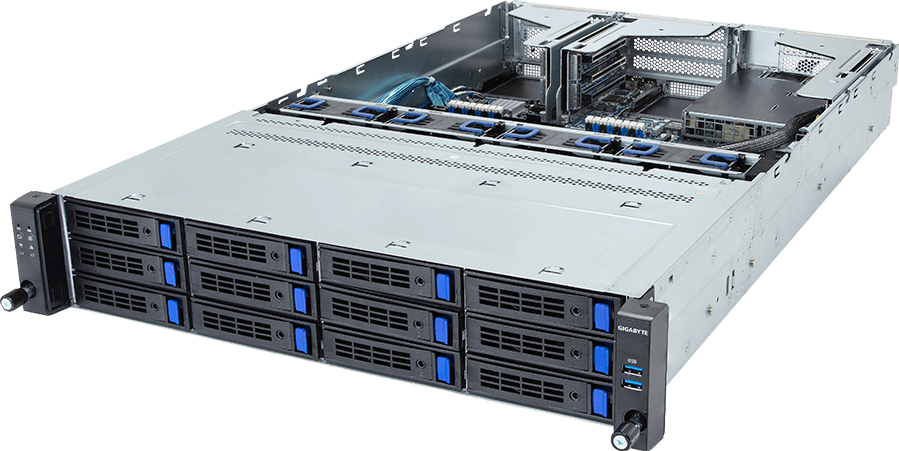
L10 es la etapa en la que un sistema de servidor barebones se configura como un servidor completo y capaz de operar de forma independiente. Los procesos habituales incluyen la instalación de CPU, GPU, memoria, dispositivos de almacenamiento, tarjetas de red, DPU y otros componentes de expansión. Según los requisitos de entrega, también pueden configurarse el BIOS, el BMC, el firmware, los controladores, la imagen del sistema operativo y el entorno de software básico.
Después del ensamblaje del hardware, el sistema se somete a pruebas de funcionalidad, compatibilidad y estabilidad a nivel de servidor. Estas pueden incluir la validación del arranque, la comprobación de las versiones de firmware, la detección de componentes, pruebas de funcionamiento de la red y el almacenamiento, pruebas de funcionamiento continuo y pruebas de estrés de las CPU, GPU, memoria y sistema de alimentación.
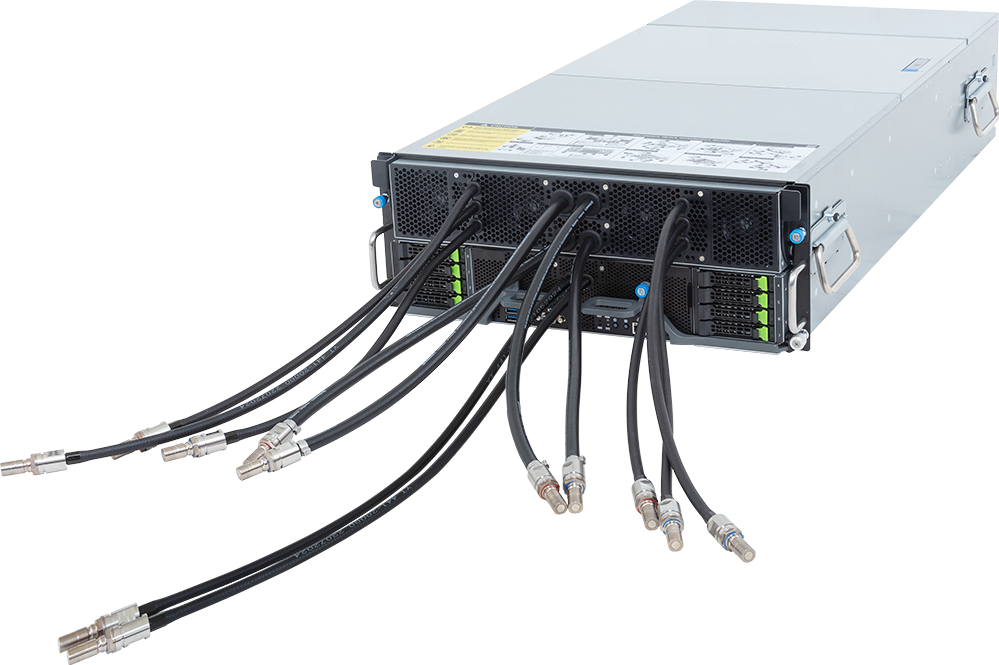
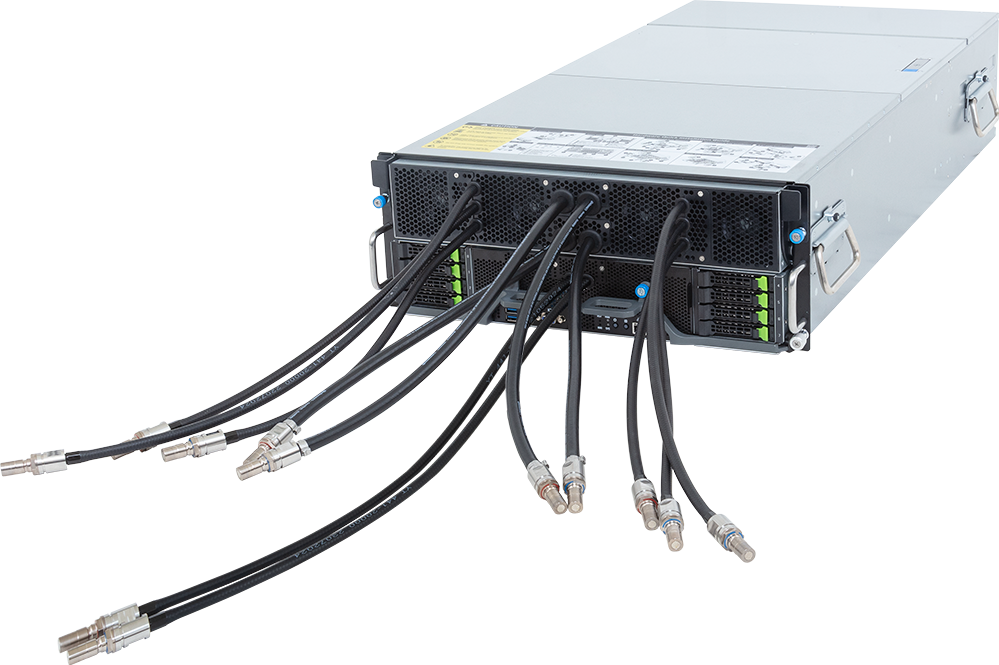
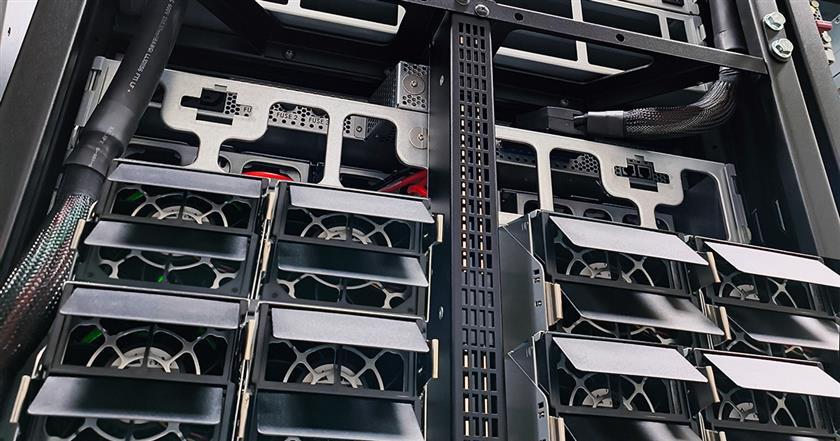
En los sistemas de refrigeración líquida directa, las placas frías internas, los circuitos de refrigeración líquida y los acoplamientos de desconexión rápida suelen ensamblarse y validarse a nivel de servidor durante esta etapa. Al finalizar L10, se obtiene un servidor completo con capacidades integradas de cómputo, almacenamiento, conectividad de red y software básico. Puede entregarse como servidor independiente o continuar con la integración a escala de rack en L11.
¿Qué es L11? Integración a escala de rack
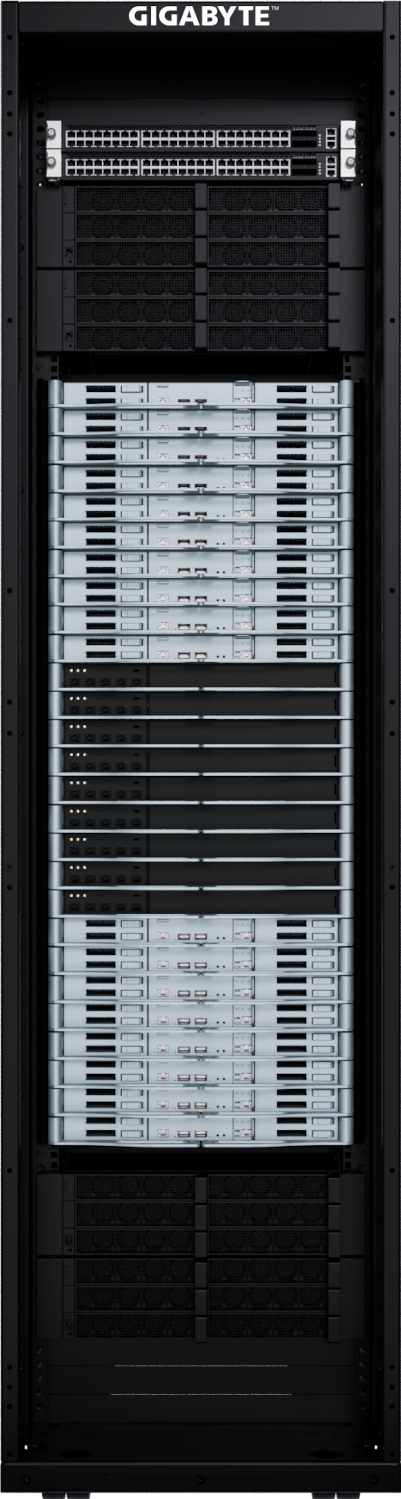
L11 integra varios servidores completos en un sistema de rack listo para su implementación. Además de instalar los servidores, switches de red y unidades de distribución de energía en el rack, esta etapa puede incluir la configuración de la alimentación eléctrica y de la red de administración, el tendido y etiquetado de cables, la homologación de las versiones de firmware entre los dispositivos y la validación térmica y del sistema a nivel de rack.
A medida que aumentan el consumo de energía y la densidad de los racks de los servidores GPU avanzados, las configuraciones de alta densidad pueden superar los límites prácticos de enfriamiento y suministro eléctrico de los centros de datos tradicionales con refrigeración por aire. Por ello, puede ser necesario implementar refrigeración líquida directa u otras soluciones avanzadas de enfriamiento. Según la arquitectura de enfriamiento y el alcance del proyecto, L11 también puede incluir manifolds de rack, tuberías de refrigeración líquida, unidades de distribución de refrigerante (CDU) y sistemas de detección de fugas, seguidos de la validación del caudal, la presión, el suministro eléctrico y la capacidad de enfriamiento.
Al finalizar L11, se obtiene un sistema de rack completo con alimentación eléctrica, redes, enfriamiento y cableado integrados. En comparación con la instalación individual de servidores en el centro de datos, la entrega a escala de rack reduce el trabajo de integración en sitio, acorta el tiempo de implementación y disminuye el riesgo de errores de configuración y de coordinación entre varios proveedores.
¿Qué es L12? Integración y validación de hardware y software a nivel de clúster
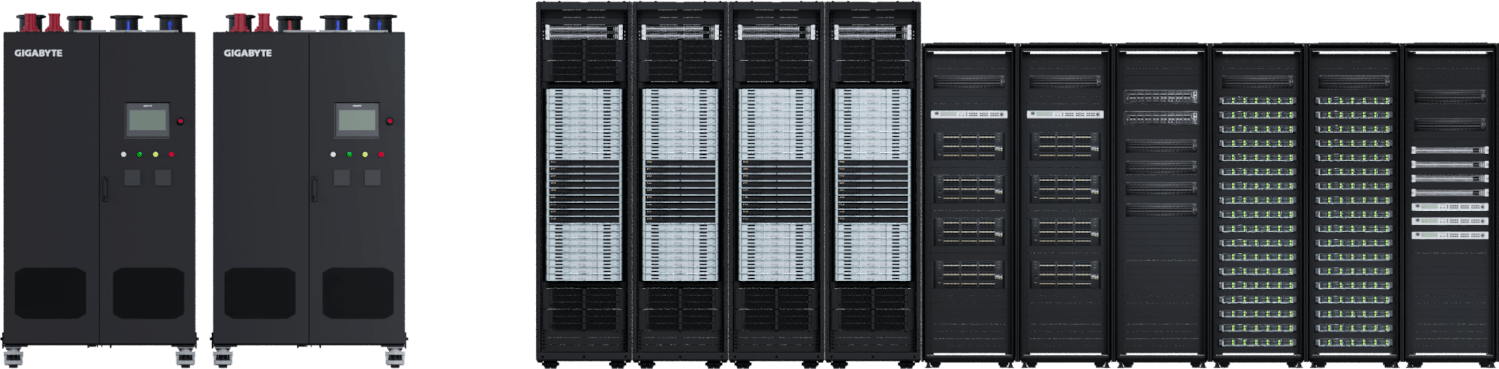
L12 integra varios racks en un clúster que puede operar como un sistema coordinado. Esta etapa generalmente incluye las conexiones de red entre racks, la configuración de la red de administración, la validación de InfiniBand o Ethernet de alta velocidad, y la implementación uniforme de sistemas operativos, controladores, firmware y entornos de software básicos.
Según los requisitos del proyecto, L12 también puede incluir la administración del clúster, la programación de recursos, plataformas de contenedores, almacenamiento paralelo y pruebas de integración con las cargas de trabajo especificadas por el cliente. La validación puede abarcar la comunicación entre nodos, el rendimiento y la latencia de la red, el rendimiento del almacenamiento, la comunicación colectiva entre GPU, pruebas de estrés de larga duración y la optimización general del rendimiento del clúster.
La escala de un sistema L12 no es fija. Puede incluir varios racks o ampliarse hasta formar un clúster de gran tamaño con cientos o miles de GPU. Su objetivo principal es garantizar que todos los componentes de cómputo, red, almacenamiento, alimentación eléctrica, enfriamiento y administración funcionen de manera confiable en un entorno de varios racks y cumplan con los objetivos de rendimiento y confiabilidad requeridos. Una vez completadas la integración y la validación en fábrica, el sistema L12 puede enviarse al centro de datos para su conexión en sitio y despliegue final.
La escala de un sistema L12 no es fija. Puede incluir varios racks o ampliarse hasta formar un clúster de gran tamaño con cientos o miles de GPU. Su objetivo principal es garantizar que todos los componentes de cómputo, red, almacenamiento, alimentación eléctrica, enfriamiento y administración funcionen de manera confiable en un entorno de varios racks y cumplan con los objetivos de rendimiento y confiabilidad requeridos. Una vez completadas la integración y la validación en fábrica, el sistema L12 puede enviarse al centro de datos para su conexión en sitio y despliegue final.
¿Cómo apoya GIGABYTE la integración de sistemas de nivel L10 a L12?
GIGABYTE ofrece capacidades de integración que abarcan desde servidores completos y sistemas a escala de rack hasta clústeres de varios racks. Según las cargas de trabajo, como IA, HPC, computación en la nube e investigación científica, GIGABYTE puede proporcionar servicios de consultoría, diseño de arquitectura, configuración de hardware, implementación de software, validación de sistemas y operación y mantenimiento continuos.
La plataforma de computación en clúster GIGAPOD puede escalar desde un solo servidor GPU hasta ocho racks con 32 nodos GPU y un total de 256 GPU. Al combinarse con GPM (GIGABYTE POD Manager), permite monitorear en tiempo real el estado del hardware y la utilización de los recursos. Los recursos de cómputo también pueden asignarse dinámicamente según los requisitos de cada carga de trabajo, lo que mejora la eficiencia de gestión y el aprovechamiento general de los recursos.
En cuanto a la refrigeración, GIGABYTE ofrece soluciones de refrigeración por aire, refrigeración líquida directa y refrigeración por inmersión. La arquitectura de refrigeración adecuada puede seleccionarse según el consumo de energía de los chips, la densidad de servidores, la configuración de los racks y las condiciones del centro de datos. Al integrar los sistemas de hardware, software, redes, energía y refrigeración, GIGABYTE ayuda a las empresas a reducir el tiempo de implementación de la infraestructura de IA y, al mismo tiempo, mejora la estabilidad, escalabilidad y eficiencia operativa de los clústeres a gran escala.