AI Tokens
KI-Tokens
Was sind KI-Tokens?
KI-Tokens sind die grundlegenden Dateneinheiten, die von Modellen der künstlichen Intelligenz verarbeitet werden. Text, Bilder, Audiodaten und andere Eingabedaten werden durch einen als Tokenisierung bezeichneten Prozess in Tokenfolgen umgewandelt, die ein KI-Modell verarbeiten kann.
In einem Large Language Model (LLM) kann ein Token ein vollständiges Wort, einen Wortteil, ein Satzzeichen oder ein anderes Textfragment repräsentieren. Ein Token entspricht daher nicht zwangsläufig einem Wort oder einem einzelnen Zeichen. Außerdem verwenden verschiedene Modelle unterschiedliche Tokenizer, sodass derselbe Inhalt zu unterschiedlichen Token-Anzahlen führen kann.
Wenn ein Benutzer einen Prompt übermittelt, verarbeitet das Modell zunächst die Eingabe-Tokens und generiert anschließend während der Inferenz Ausgabe-Tokens. Diese Ausgabe-Tokens werden in die für den Benutzer sichtbare Antwort umgewandelt.
Warum sind KI-Tokens wichtig?
Die Tokenanzahl beeinflusst, wie viele Daten ein KI-Modell verarbeiten muss, und wird häufig auch zur Messung der Nutzung und Kosten generativer KI-Dienste verwendet.
Das Kontextfenster eines LLM wird typischerweise in Tokens gemessen und bestimmt, wie viele Informationen das Modell gleichzeitig verarbeiten kann. Ein größeres Kontextfenster kann längere Dokumente, Gespräche oder andere Kontextinformationen aufnehmen, erfordert jedoch zusätzliche Rechen- und Speicherkapazitäten.
Da Reasoning-Modelle und agentenbasierte KI längere und komplexere Workflows ausführen, kann eine einzelne Aufgabe eine erheblich größere Tokenanzahl umfassen. NVIDIA-CEO Jensen Huang erklärte auf der GTC 2026, dass der Bedarf an KI-Rechenleistung in den vergangenen Jahren um etwa das Eine-Millionenfache gestiegen ist. Google gab ebenfalls bekannt, dass seine KI-Systeme im selben Jahr monatlich mehr als 3,2 Billiarden Tokens verarbeiten – gegenüber 9,7 Billionen zwei Jahre zuvor. Das entspricht einem Anstieg um mehr als das 300-Fache. Mit weiter zunehmenden Tokenvolumen werden Token-Durchsatz, Latenz und Kosten zu immer wichtigeren Kennzahlen für die KI-Inferenz.
Wie funktioniert Tokenisierung?
Tokenisierung wandelt Rohdaten in Tokens um, die ein KI-Modell verarbeiten kann. Bei Text wendet ein Tokenizer ein modellspezifisches Vokabular und bestimmte Kodierungsregeln an, um den Inhalt in kleinere Einheiten zu unterteilen und jedem Token eine numerische Repräsentation für die Verarbeitung zuzuweisen.
Ein häufig verwendetes Wort kann aus nur einem Token bestehen, während ein längeres oder selteneres Wort in mehrere Tokens unterteilt werden kann. Sprache, Zeichensetzung, Sonderzeichen und das Design des Tokenizers können das Ergebnis beeinflussen. Daher kann derselbe Inhalt bei verschiedenen KI-Modellen zu unterschiedlichen Tokenanzahlen führen.
Multimodale KI-Modelle können auch Bilder, Audio- und Videodaten in Tokens oder ähnliche Repräsentationen umwandeln, die das Modell verarbeiten kann.
Wie werden AI-Token gezählt und abgerechnet?
Es gibt keine allgemeingültige Formel zur Umrechnung von Wörtern oder Zeichen in AI-Token. Die tatsächliche Anzahl hängt vom Tokenizer sowie von der Sprache und dem verwendeten Inhalt des jeweiligen Modells ab.
Generative-AI-Dienste unterscheiden in der Regel zwischen Eingabe- und Ausgabetokens. Eingabetokens umfassen Prompts, Dokumente und andere Kontextinformationen, die dem Modell bereitgestellt werden, während Ausgabetokens während der Antwortgenerierung des Modells erzeugt werden. Einige Dienste berücksichtigen möglicherweise auch Cache-Tokens. Dabei handelt es sich um wiederverwendbare Eingabeinhalte, die nicht erneut vollständig verarbeitet werden müssen. Darüber hinaus gibt es Reasoning-Tokens, die das Modell während seines internen Schlussfolgerungsprozesses vor der Generierung einer Antwort verwendet. Die konkreten Tokenkategorien, Zählmethoden und Abrechnungsmodelle unterscheiden sich je nach Anbieter.
Neben der Gesamtanzahl der Tokens wird häufig die Anzahl der Tokens pro Sekunde zur Messung der Generierungsgeschwindigkeit verwendet. Die Time to First Token (TTFT) misst dagegen die Verzögerung zwischen einer Anfrage und dem ersten erzeugten Token. Bei AI-Plattformen, die viele Nutzer gleichzeitig bedienen, können diese Metriken sowohl die Benutzererfahrung als auch die Effizienz der Infrastruktur unmittelbar beeinflussen.
Wie unterstützt GIGABYTE?
Da generative KI, Reasoning-Modelle und agentische KI-Prozesse immer größere Tokenmengen verarbeiten, muss die Infrastruktur für KI-Inferenz GPU-Beschleunigung und CPU-Verarbeitung, Speicherkapazität, Datenbewegung, Kühlung und Energieeffizienz ausgewogen aufeinander abstimmen.
GPUs eignen sich besonders für hochgradig parallele KI-Inferenz-Workloads wie große Sprachmodelle und multimodale Modelle. CPUs spielen jedoch weiterhin eine wichtige Rolle bei der Datenverarbeitung, bei Anwendungsdiensten, der Modellorchestrierung und in Workflows für agentische KI. Wenn KI-Agenten Daten abrufen, APIs aufrufen, externe Tools nutzen oder mehrere Aufgaben koordinieren, arbeiten CPU- und GPU-Ressourcen im gesamten KI-System zusammen.
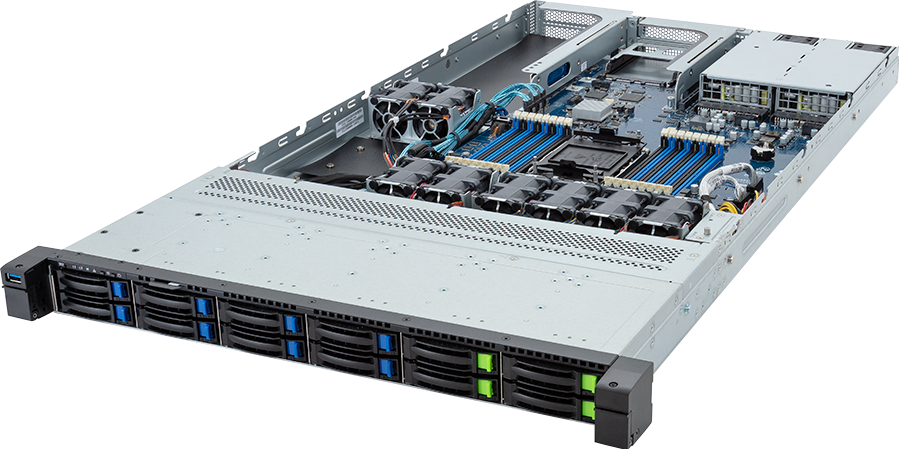
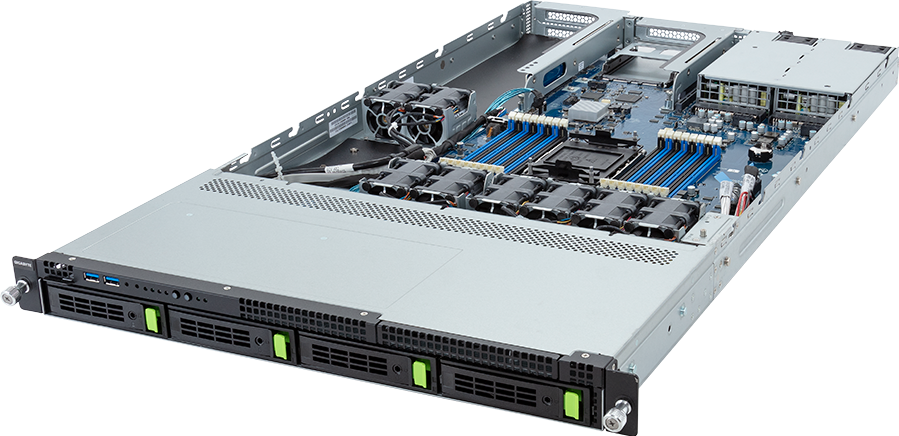
GIGABYTE bietet ein breites Portfolio – von leistungsstarken CPU- und GPU-Servern bis hin zu KI-Computing-Plattformen im Rack-Maßstab – für unterschiedliche Arten und Größenordnungen von KI-Inferenz-Workloads. Mit GIGAPOD, dem GIGABYTE POD Manager (GPM) und fortschrittlichen Kühltechnologien wie direkter Flüssigkeitskühlung unterstützt GIGABYTE Unternehmen beim Aufbau skalierbarer KI-Infrastrukturen für Inferenz mit hohem Durchsatz und geringer Latenz.