LLM (Large Language Model)
Großes Sprachmodell
Was ist ein großes Sprachmodell (LLM, Large Language Model)?
Ein großes Sprachmodell (LLM) ist ein Modell der künstlichen Intelligenz (KI), das menschliche Sprache ohne zusätzliche Programmierung verstehen und mithilfe der sogenannten natürlichen Sprachverarbeitung (Natural Language Processing, NLP) Texte erzeugen kann, die von menschlich verfassten Texten nicht zu unterscheiden sind. Zu den bekannten LLMs auf dem Markt gehören die GPT-Serie von OpenAI, die LLaMA-Familie von Meta und das Open-Source-Modell BLOOM. Zahlreiche generative KI-Dienste für Sprache basieren auf LLMs, darunter ChatGPT von OpenAI, Google Bard und Microsoft Bing Chat.
Im Kern ist ein LLM ein künstliches neuronales Netzwerk (KNN), das eine als „Transformer“ bezeichnete Deep-Learning-Architektur verwendet. Der Mechanismus zur parallelen Verarbeitung des Transformers ermöglicht das KI-Training mit riesigen Mengen sprachbezogener Big Data – beispielsweise der gesamten Wikipedia – und Datenparametern, deren Anzahl in die Milliarden oder sogar Billionen geht. Während des Trainings versucht das KI-Modell, für eine bestimmte Eingabe die richtige Ausgabe vorherzusagen, etwa das nächste Wort in einem Satz oder eine passende Antwort auf eine Anfrage, und überprüft anschließend seine Antworten. Je nachdem, ob die Vorhersage korrekt war, passt das KI-Modell die „Bias-Werte“ oder „Gewichte“ seiner Datenparameter an, bis es nahezu immer die richtige Ausgabe erzeugt. Deshalb können auf LLMs basierende KI-Dienste menschliche Sprache problemlos verstehen und darauf antworten. Beispiele aus der Praxis sind ein Chatbot im Kundensupport, der präzise auf Beschwerden mit Rechtschreib- oder Grammatikfehlern reagiert, oder ChatGPT, das innerhalb weniger Sekunden Gedichte und Lebensläufe verfasst.
Weitere Informationen: Was ist RAG und wie funktioniert es?
Welche Anwendungsmöglichkeiten gibt es für große Sprachmodelle?
Ohne große Sprachmodelle wäre die Kommunikation mit einem Computer auf die Eingabe von Befehlen (denken Sie an MS-DOS) oder auf eine vorab entwickelte grafische Benutzeroberfläche (GUI) beschränkt. Zu erwarten, dass der Computer auf natürliche Sprache reagiert, wäre reine Zukunftsmusik. Dank der zunehmenden Verbreitung großer Sprachmodelle stehen heute zahlreiche neue KI-basierte Dienste zur Verfügung:
● Suchmaschinen und Chatbots: Die Technologie großer Sprachmodelle hat diese beliebten Funktionen um KI erweitert. Suchmaschinen und Chatbots können unsere Anfragen nicht nur mit erstaunlicher Genauigkeit verstehen, sondern haben auch eine neue Generation KI-gestützter PCs und Geräte hervorgebracht.
● Generative KI: Tools wie ChatGPT können Dokumente zusammenfassen und übersetzen sowie völlig neue Inhalte wie Briefe und Drehbücher für Fernsehsendungen verfassen.
● Gesundheitswesen und Medizin: Intelligente, auf großen Sprachmodellen basierende Anwendungen im Gesundheitswesen können elektronische Patientenakten (EHR) erstellen. Dadurch wird das medizinische Personal von Verwaltungsaufgaben entlastet und es werden Datenbanken für Analysen im Gesundheitswesen aufgebaut.
● Programmierung und KI-Entwicklung: GitHub Copilot, das von Microsoft und OpenAI entwickelt wurde, kann Computercode in JavaScript, Python und anderen Programmiersprachen schreiben. Das ist besonders bemerkenswert, weil große Sprachmodelle damit letztlich die Programmierung künftiger KI-Tools ermöglichen.
Wie unterstützt GIGABYTE Sie?
GIGABYTE Technology bietet sowohl Hardware- als auch Softwarelösungen für die Arbeit mit großen Sprachmodellen (LLMs) und generativen KI-Diensten auf Basis großer Sprachmodelle.
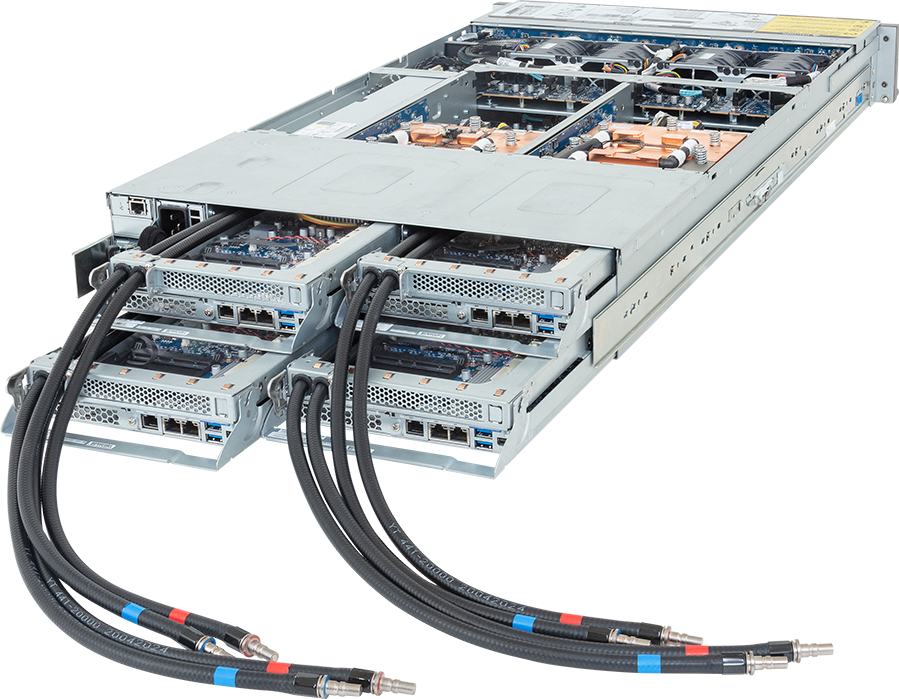
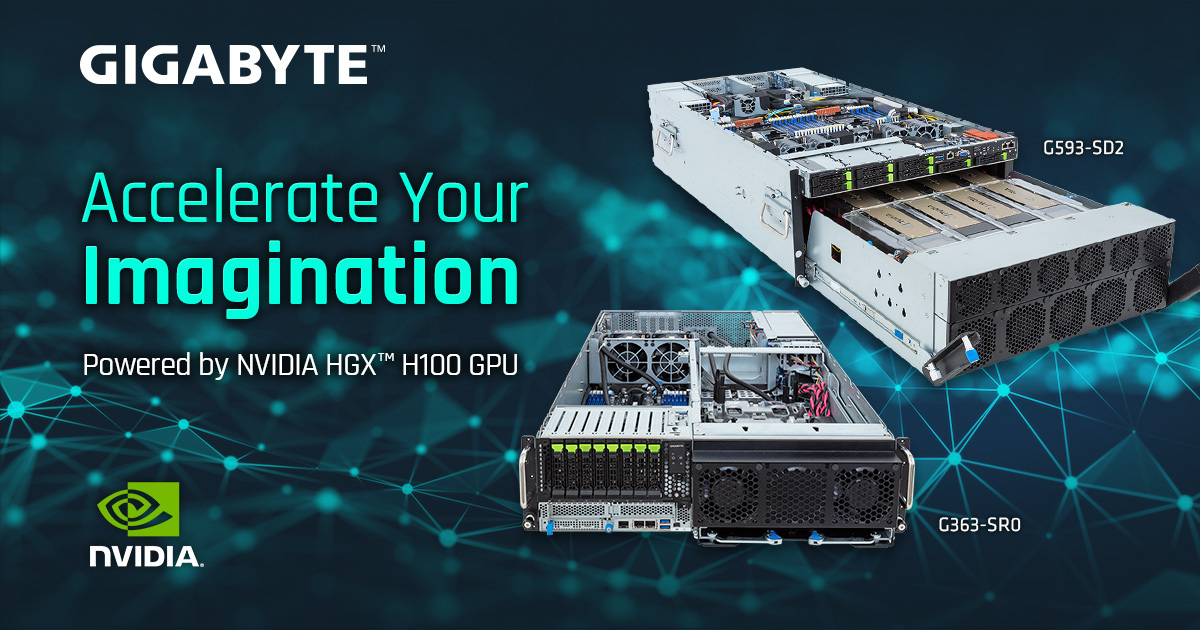
Auf der Hardwareseite stellt GIGABYTE KI-Server bereit, die speziell für die Rechen- und Datenspeicheranforderungen beim Training von KI-Modellen geeignet sind. So ist der G593-SD0 von GIGABYTE der weltweit erste NVIDIA-zertifizierte HGX™ H100 8-GPU-SXM5-Server. Er ist mit dem NVIDIA HGX™ H100 8-GPU-Computing-Modul ausgestattet und bietet dadurch eine äußerst leistungsfähige KI-Computing-Plattform. Weitere Produkte aus der G-Serie der GPU-Server von GIGABYTE können ebenfalls mit modernen GPU-Beschleunigern wie NVIDIA L40S ausgestattet werden, um Workloads mit großen Sprachmodellen zu unterstützen. Für die Datenspeicherung wurde der S-Series Storage Server S183-SH0 von GIGABYTE speziell für große Sprachmodelle entwickelt. Durch den Einsatz von EDSFF-E1.S-Solid-State-Laufwerken (SSDs) bietet er All-Flash-Array-(AFA)-Speicher. Diese profitieren von PCIe-Gen5- und NVMe-Schnittstellentechnologien, sodass der Server die hohen Anforderungen an die schnelle Speicherung und den schnellen Abruf von Daten bei der Entwicklung großer Sprachmodelle erfüllt.
Auf der Softwareseite bietet das Beteiligungsunternehmen MyelinTek Inc. von GIGABYTE das MLSteam DNN Training System, eine „MLOps-Plattform“, die NLP- und LLM-Anwendungen unterstützt. Das MLSteam DNN Training System kann Open-Source-LLMs wie BLOOM für die vom Kunden bevorzugte GPU-Beschleunigungssoftwareplattform optimieren, beispielsweise AMD ROCm oder NVIDIA CUDA.