AI Tokens
Tokens de IA
¿Qué son los tokens de IA?
Los tokens de IA son las unidades básicas de datos que procesan los modelos de inteligencia artificial. El texto, las imágenes, el audio y otros datos de entrada se convierten, mediante un proceso llamado tokenización, en secuencias de tokens que un modelo de IA puede procesar.
En un modelo de lenguaje de gran escala (LLM), un token puede representar una palabra completa, parte de una palabra, un signo de puntuación u otro fragmento de texto. Por lo tanto, un token no equivale necesariamente a una palabra ni a un carácter. Además, cada modelo puede utilizar un tokenizador diferente, por lo que el mismo contenido puede producir un número distinto de tokens.
Cuando un usuario envía un prompt, el modelo procesa primero los tokens de entrada y después genera tokens de salida durante la inferencia. Estos tokens de salida se convierten en la respuesta que ve el usuario.
¿Por qué son importantes los tokens de IA?
La cantidad de tokens determina cuántos datos debe procesar un modelo de IA y también se utiliza comúnmente para medir el uso y el costo de los servicios de IA generativa.
La ventana de contexto de un LLM normalmente se mide en tokens y determina cuánta información puede procesar el modelo al mismo tiempo. Una ventana de contexto más amplia puede admitir documentos, conversaciones u otra información contextual más extensos, pero también requiere recursos adicionales de cómputo y memoria.
A medida que los modelos de razonamiento y la IA agéntica ejecutan flujos de trabajo más largos y complejos, una sola tarea puede involucrar una cantidad considerablemente mayor de tokens. Jensen Huang, director ejecutivo de NVIDIA, señaló en GTC 2026 que la demanda de cómputo para IA ha aumentado aproximadamente un millón de veces en los últimos años. Google también anunció ese mismo año que sus sistemas de IA procesan más de 3.2 cuatrillones de tokens al mes, frente a los 9.7 billones de dos años antes, lo que representa un aumento de más de 300 veces. A medida que los volúmenes de tokens continúan creciendo, el rendimiento de tokens, la latencia y el costo se convierten en métricas cada vez más importantes para la inferencia de IA.
¿Cómo funciona la tokenización?
La tokenización convierte los datos sin procesar en tokens que un modelo de IA puede procesar. En el caso del texto, un tokenizador aplica un vocabulario y reglas de codificación específicos del modelo para dividir el contenido en unidades más pequeñas y asignar a cada token una representación numérica que se utiliza en los cálculos.
Una palabra común puede requerir un solo token, mientras que una palabra más larga o menos frecuente puede dividirse en varios. El idioma, la puntuación, los caracteres especiales y el diseño del tokenizador pueden afectar el resultado, por lo que un mismo contenido puede generar un número diferente de tokens en distintos modelos de IA.
Los modelos de IA multimodal también pueden convertir imágenes, audio y video en tokens o en representaciones similares que el modelo puede procesar.
¿Cómo se calculan y facturan los recuentos de tokens de IA?
No existe una fórmula universal para convertir palabras o caracteres en tokens de IA. El recuento real depende del tokenizador, el idioma y el contenido utilizados por cada modelo.
Por lo general, los servicios de IA generativa distinguen entre tokens de entrada y tokens de salida. Los tokens de entrada incluyen los prompts, documentos y demás información contextual que se proporciona al modelo, mientras que los tokens de salida se generan a medida que el modelo responde. Algunos servicios también pueden contabilizar tokens en caché, que corresponden a contenido de entrada reutilizable que no necesita procesarse por completo nuevamente, y tokens de razonamiento, que se utilizan durante el proceso de razonamiento interno del modelo antes de generar una respuesta. Las categorías de tokens, los métodos de conteo y las estructuras de facturación específicas varían según el proveedor.
Además del recuento total de tokens, los tokens por segundo se utilizan habitualmente para medir la velocidad de generación, mientras que el tiempo hasta el primer token (TTFT) mide el retraso entre una solicitud y el primer token generado. En las plataformas de IA que atienden a muchos usuarios de forma simultánea, estas métricas pueden afectar directamente tanto la experiencia del usuario como la eficiencia de la infraestructura.
¿Cómo ayuda GIGABYTE?
A medida que la IA generativa, los modelos de razonamiento y la IA agéntica procesan volúmenes cada vez mayores de tokens, la infraestructura de inferencia de IA debe equilibrar la aceleración mediante GPU con la capacidad de cómputo de la CPU, la capacidad de memoria, el movimiento de datos, la refrigeración y la eficiencia energética.
Las GPU son ideales para cargas de trabajo de inferencia de IA altamente paralelas, como las de los modelos de lenguaje de gran escala y los modelos multimodales. Por su parte, las CPU siguen desempeñando un papel importante en el procesamiento de datos, los servicios de aplicaciones, la orquestación de modelos y los flujos de trabajo de IA agéntica. Cuando los agentes de IA recuperan datos, llaman a API, utilizan herramientas externas o coordinan varias tareas, los recursos de CPU y GPU trabajan en conjunto en todo el sistema de IA.
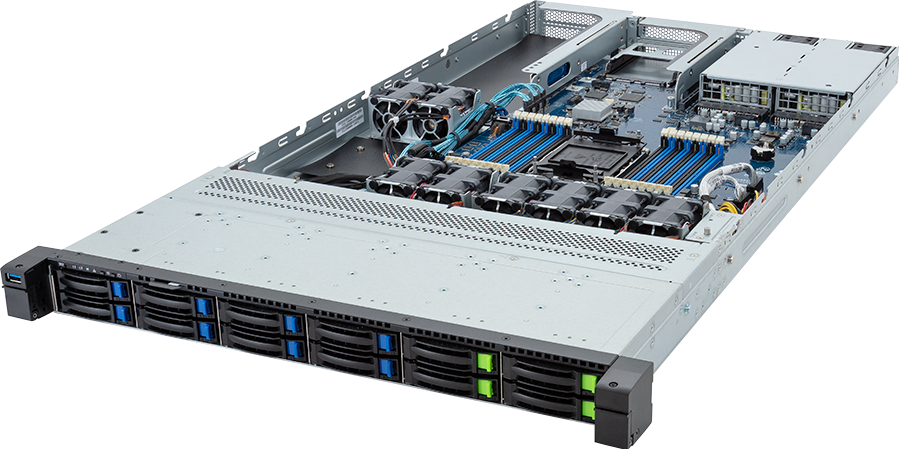
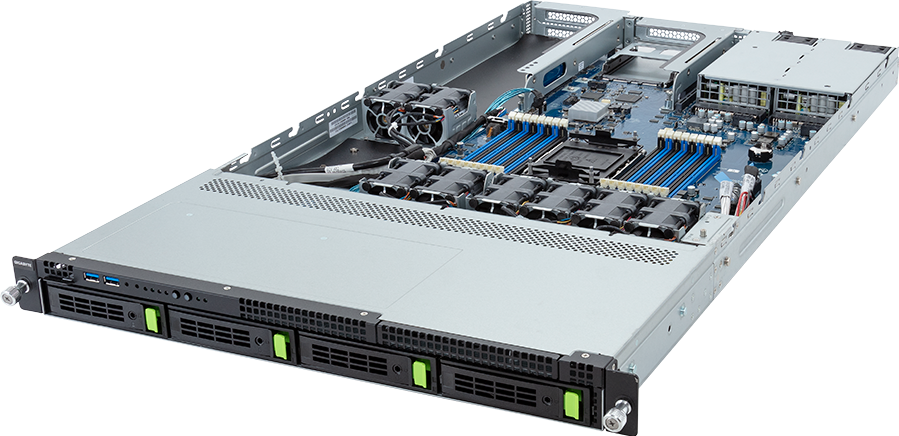
GIGABYTE ofrece un amplio portafolio que abarca desde servidores con CPU de alto rendimiento y servidores con GPU hasta plataformas de cómputo de IA a escala de rack, diseñadas para distintos tipos y escalas de cargas de trabajo de inferencia de IA. Con GIGAPOD, GIGABYTE POD Manager (GPM) y tecnologías avanzadas de refrigeración, como la refrigeración líquida directa, GIGABYTE ayuda a las organizaciones a crear una infraestructura de IA escalable para lograr una inferencia de alto rendimiento y baja latencia.