AI Training
Entraînement de l’IA
De quoi s’agit-il ?
L’intelligence artificielle (IA) moderne est capable d’effectuer une grande variété de tâches, de la génération de textes et d’images au pilotage d’une voiture autonome, car elle est développée au moyen d’un processus appelé apprentissage automatique ou apprentissage profond. Les deux principales composantes de l’apprentissage sont l’« entraînement » et l’« inférence ».
Lors de l’entraînement, une quantité considérable de données est fournie au modèle d’IA. Ces données sont généralement étiquetées et des programmeurs sont présents pour superviser le processus. Toutefois, les systèmes d’IA les plus avancés peuvent effectuer un entraînement auto-supervisé ou semi-supervisé à partir de données non étiquetées. L’IA analyse les données d’entrée et tente de produire le résultat attendu. Elle peut, par exemple, chercher à identifier les photos de chiens au milieu d’un grand nombre d’images d’animaux. En fonction de la validité du résultat obtenu, c’est-à-dire de la justesse ou non de sa prédiction, l’IA ajuste son processus de prise de décision en attribuant des scores pondérés, également appelés « biais », aux paramètres des données.
À force de répéter les itérations de prédictions (propagations avant) et de rétroactions (rétropropagations), les pondérations deviennent si précises que les bonnes connexions sont systématiquement sélectionnées. C’est ainsi que l’IA est entraînée à reconnaître les données pour lesquelles elle a été conçue.
Pourquoi est-il nécessaire ?
Avec l’inférence, l’entraînement de l’IA constitue une composante essentielle et indissociable du fonctionnement des systèmes d’IA modernes, qui « apprennent ». Plutôt que de demander aux programmeurs humains d’écrire du code pour chaque situation possible, l’IA s’entraîne en analysant une quantité considérable de données massives, jusqu’à être prête à traiter des données nouvelles et non étiquetées dans des situations réelles.
Prenons l’exemple de la vision par ordinateur appliquée à la reconnaissance des plaques d’immatriculation. Les stations de péage électronique sur autoroute doivent pouvoir lire les lettres et les chiffres des plaques des véhicules qui passent. Les plaques peuvent utiliser des polices différentes ; elles peuvent être de travers, inclinées ou tachées ; les véhicules peuvent circuler à des vitesses variables. Si l’IA parvient malgré tout à lire correctement ces informations, c’est uniquement parce qu’elle a été entraînée sur une quantité de données suffisamment importante pour interpréter précisément les données d’entrée à chaque fois.
Comment GIGABYTE vous aide-t-il ?
La quantité de données numériques et de ressources de calcul nécessaires à l’entraînement de l’IA est non seulement considérable, mais elle augmente également de façon exponentielle. L’utilisation d’une infrastructure d’IA dotée d’une accélération GPU et du calcul parallèle est indispensable, d’autant plus que les développeurs concurrents se livrent eux aussi à une course effrénée pour commercialiser leurs produits d’IA.
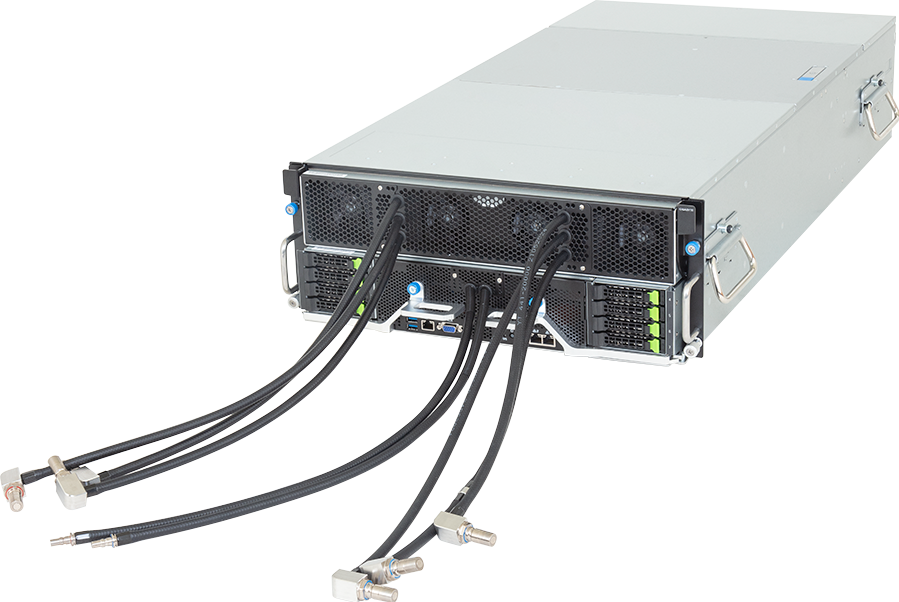
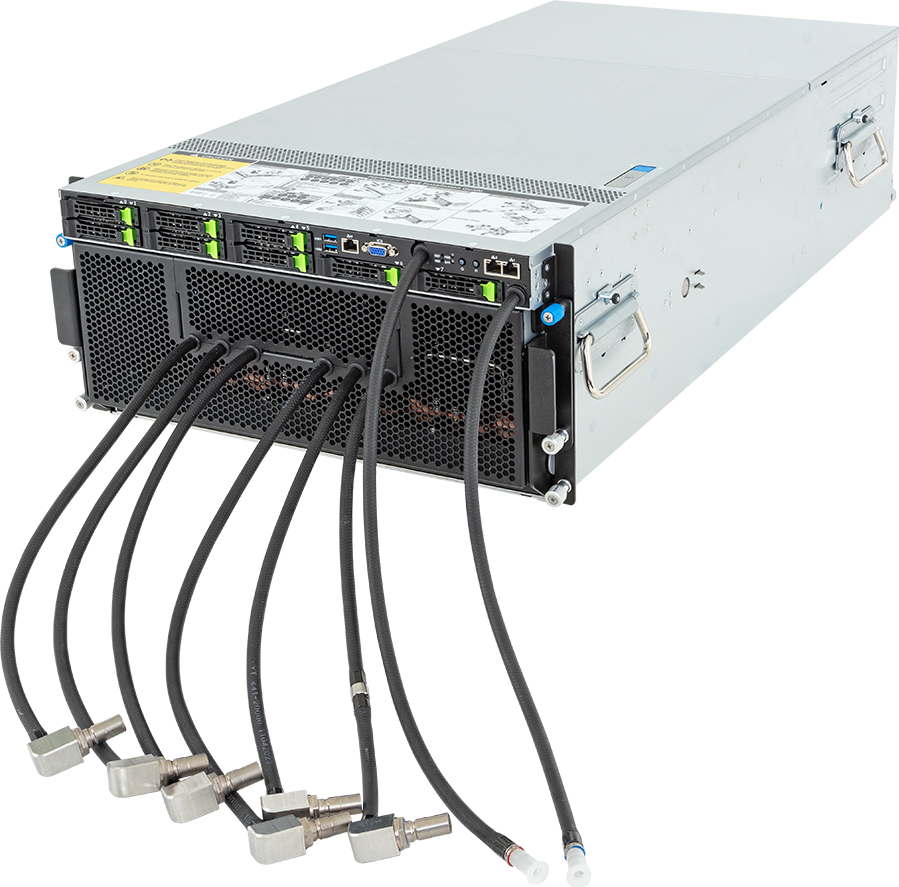
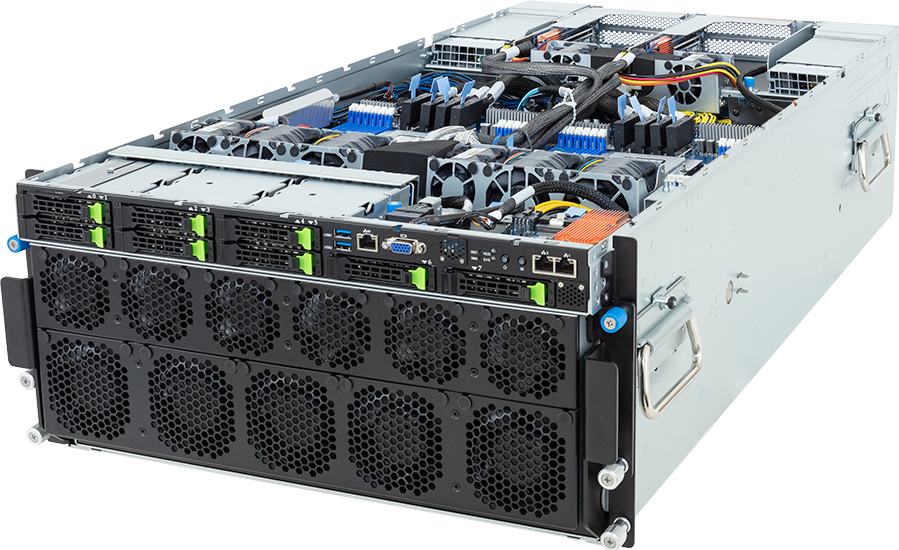
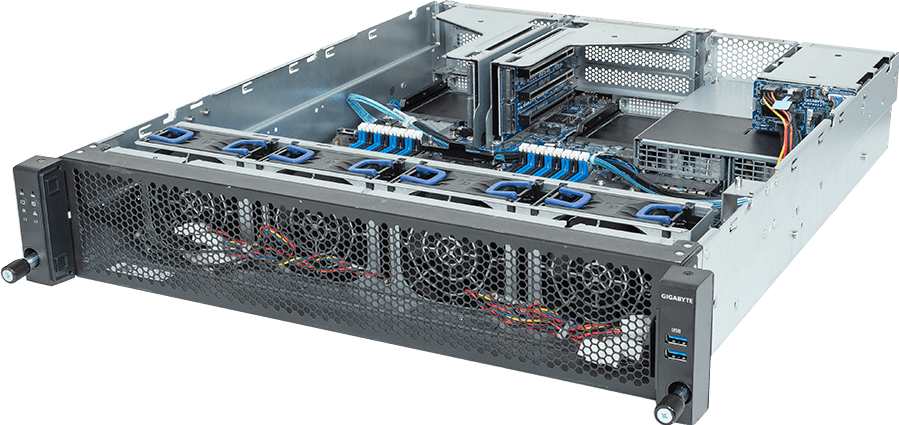
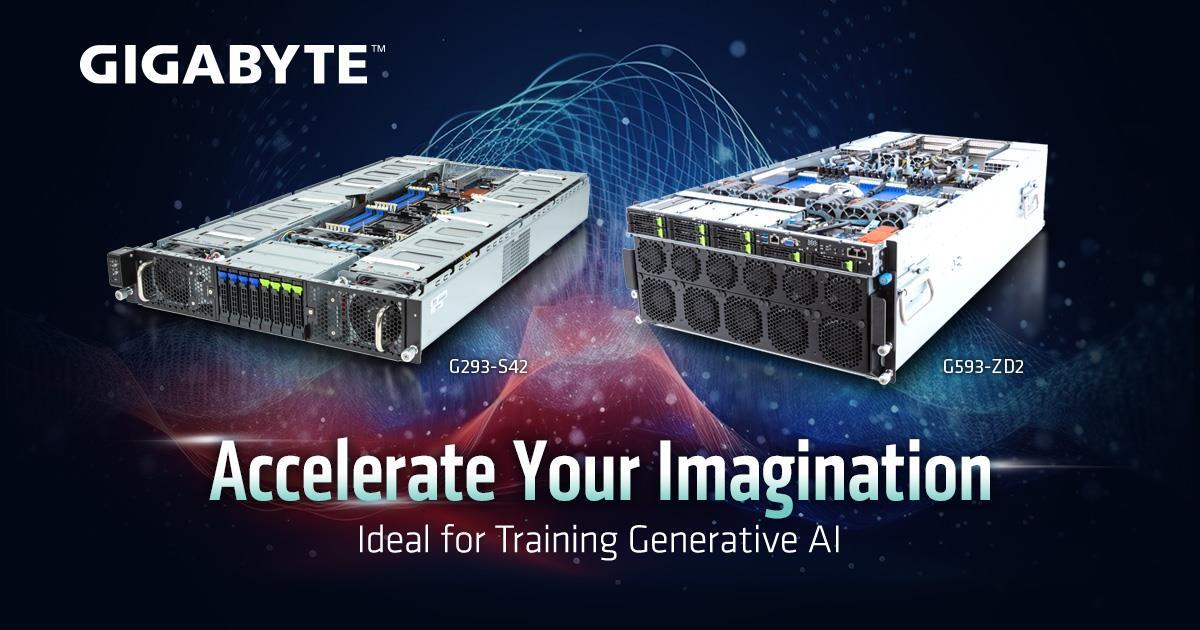
Les serveurs GPU de la série G de GIGABYTE Technology comptent parmi les serveurs d’IA les plus puissants du secteur. Les modèles G593-SD0 et G593-ZD2 associent respectivement le module de calcul NVIDIA HGX™ H100 à 8 GPU aux processeurs Intel® Xeon® Scalable de 4e génération et AMD EPYC™ 9004. Ils offrent plus de 32 pétaFLOPS de performances de calcul pour l’IA, ce qui en fait des solutions parfaitement adaptées aux applications de traitement automatique du langage naturel (TALN) et de grands modèles de langage (LLM). Toute cette puissance de calcul peut être intégrée dans un serveur 5U grâce aux technologies de refroidissement et à la conception de châssis propriétaires de GIGABYTE, qui contribuent à améliorer la densité de calcul.
En plus de proposer des serveurs de pointe, la pile logicielle de GIGABYTE, qui comprend GIGABYTE POD Manager (GPM) et GIGABYTE AI Platform (GAIP), peut accompagner votre usine d’IA de la conception à la mise en production et fournir aux architectes, aux équipes d’infrastructure, aux administrateurs informatiques et aux développeurs d’IA les outils adaptés à leurs responsabilités.
En savoir plus : 《Accélérez l’IA avec les solutions de serveurs d’IA haute performance de GIGABYTE》
Les serveurs GPU de la série G de GIGABYTE Technology comptent parmi les serveurs d’IA les plus puissants du secteur. Les modèles G593-SD0 et G593-ZD2 associent respectivement le module de calcul NVIDIA HGX™ H100 à 8 GPU aux processeurs Intel® Xeon® Scalable de 4e génération et AMD EPYC™ 9004. Ils offrent plus de 32 pétaFLOPS de performances de calcul pour l’IA, ce qui en fait des solutions parfaitement adaptées aux applications de traitement automatique du langage naturel (TALN) et de grands modèles de langage (LLM). Toute cette puissance de calcul peut être intégrée dans un serveur 5U grâce aux technologies de refroidissement et à la conception de châssis propriétaires de GIGABYTE, qui contribuent à améliorer la densité de calcul.
En plus de proposer des serveurs de pointe, la pile logicielle de GIGABYTE, qui comprend GIGABYTE POD Manager (GPM) et GIGABYTE AI Platform (GAIP), peut accompagner votre usine d’IA de la conception à la mise en production et fournir aux architectes, aux équipes d’infrastructure, aux administrateurs informatiques et aux développeurs d’IA les outils adaptés à leurs responsabilités.
En savoir plus : 《Accélérez l’IA avec les solutions de serveurs d’IA haute performance de GIGABYTE》